LLVM-libc Doğru Yuvarlamalı Matematik: Ne Değişiyor?
MSVC, /Zc:cmath etkinken matematik fonksiyonlarının hem derleme zamanı değerlendirmesinde hem de çalışma zamanı yürütmesinde LLVM-libc’i kullanıyor. Microsoft C++ derleyici ekibinden Cody Miller’ın davetiyle LLVM-libc sorumlusu Michael Jones ve matematik kütüphanesinin mimarı Tue Ly, işin arka planını anlatan bir konuk yazı yayımladı. Yazının teknik gerekçeleri üç soruda toplanıyor: LLVM-libc neden “kütüphane olarak libc” diye tasarlandı, doğru yuvarlama (correct rounding) hangi somut üretim sorunlarını çözüyor, tüm bitleri garanti eden bir kütüphane nasıl olup da yavaşlamıyor.
“Kütüphane olarak libc”: LLVM-libc’in tasarım felsefesi
C standart kütüphanesi (libc) uygulamaları genellikle belirli bir hedef için yazılır. Çoğu, dayandıkları işletim sistemi arayüzüne sıkı sıkıya bağlı monolitik kütüphanelerdir ve tek tek fonksiyonları birbirinden ayırmak için özel bir çaba göstermezler. Daha küçük parçalara bölmek de bu yüzden zordur.
LLVM-libc 2019’da farklı bir tasarım felsefesiyle başlatıldı: taşınabilirlik, modülerlik ve yeniden kullanılabilir, temiz C++. Özgün tasarım bunu “libc as a library” (kütüphane olarak libc) diye tanımlıyor, yani deyimsel bir C/C++ kütüphanesine çok daha yakın bir yapı. Projede en başından beri işletim sistemi arayüz katmanı ile genel arayüz birbirinden ayrı tutuldu, her fonksiyon bağımsız hale getirildi. Taşınabilirlik hedefi, mutlak gerekli olmadıkça assembly kullanmamayı da beraberinde getirdi; bunun ek faydası, derleyicinin kod üzerinde daha derin optimizasyonlar yapabilmesi oldu.
Bu modüler yapı sayesinde kod parçaları LLVM ekosisteminde paylaşılabilir hale geldi. Michael Jones’un başlattığı Project Hand-in-Hand, LLVM’in libc++ projesinin LLVM-libc ile aynı float-to-string dönüşüm kodunu kullanmasını sağladı. OpenMP printf çekirdeğini, compiler-rt ise yazılımsal kayan nokta desteğini LLVM-libc’ten alıyor. Yakında hem clang hem MSVC, constexpr değerlendirme için LLVM-libc’in matematik kütüphanesini kullanacak. LLVM-libc’in matematiğini derleyici kullanımına uygun kılan ne peki?
Aynı kod neden farklı sonuç veriyor?
Yazıda kullanıcıların matematik kütüphanelerinde önemsediği dört boyut sıralanıyor: kararlılık (stability), doğruluk (accuracy), tutarlılık (consistency) ve performans. Kayan nokta aritmetiği çoğu zaman kara büyü gibi görülür, farklı platform veya derleyicide farklı sonuç görenler “kayan nokta zaten kesin değil” deyip geçer. Oysa gösterimin kesin olmaması, matematiksel işlemlerin belirlenimsiz (non-deterministic) olmak zorunda olduğu anlamına gelmez.
Geleneksel libm uygulamaları platformdan platforma ve sürümden sürüme farklı sonuçlar üretir. Üretim sistemlerinde bu, üç somut probleme yol açıyor:
Komut seviyesinde ayrışma
Donanım tasarımcıları matematik işlemlerini silikonda hızlandırmaya çalıştığında (hızlı karşılık karekök veya transandantal fonksiyonlar gibi), farklı CPU üreticileri farklı ödünleşimler seçiyor. Sonuçta tamamen aynı C++ kodu Intel, AMD, ARM veya bir GPU üzerinde birbirinden hafifçe farklı sayılar üretebiliyor.
Hata-uyumluluğu (bug-for-bug compatibility) tuzağı
Hatalı bir matematik rutini büyük bir platformda veya işletim sisteminde yayıldıktan sonra, alt katmandaki yazılımlar kaçınılmaz olarak o bitlere bel bağlıyor. Klasik örnek eski x87 transandantal komutları FSIN ve FCOS. Intel’in özgün donanım uygulaması argüman indirgeme için π’nin 66 bitlik kesilmiş bir yaklaşımını kullanıyordu; Bruce Dawson’ın “Intel Underestimates Error Bounds by 1.3 quintillion” başlıklı yazısında belgelediği gibi, bazı girdilerde bu, ULP (Units in the Last Place) cinsinden devasa hatalara yol açıyor. Intel x87 çıktısını bekleyen yazılımlarla hata düzeyinde uyumluluğu korumak için AMD da x87 komut kümesinde aynı 66 bitlik indirgeme davranışını benimsedi, x86 ekosistemi bu eski davranışa kilitlendi. Üstelik bu eski komutlar modern işlemcilerde mikrokodlu olduğundan, Payne-Hanek gibi modern aralık indirgeme algoritmalarını kullanan optimize yazılım uygulamalarından çok daha yavaş çalışıyor.
Golden testlerin kırılması
Golden testler, belirli bir girdinin tutarlı bir çıktı verdiğini sabit bir “altın” sonuçla karşılaştırarak doğrular; sonuç kararlılığının önemli olduğu görüntü işleme hatlarında yaygındır. Bir kütüphane yalnızca gevşek bir hata sınırı garanti ediyorsa, iç optimizasyonlar veya hata düzeltmeleri çıktı bitlerini kaydırabilir. std::sin veya std::pow içindeki 1 ULP’lik küçücük bir kayma yüzlerce golden testi geçersiz kılabilir, ekipler de zamanını test referanslarını güncellemeye harcar.
Derleyici bayrakları neden yetmiyor?
Geliştiriciler bu farklarla uzun süredir uğraşıyor. Oyun motorları ve lockstep simülasyonlar tarafında Bruce Dawson (Random ASCII, ara hassasiyet üzerine yazıları dahil), Glenn Fiedler (Gaffer on Games) ve Forrest Smith’in (Planetary Annihilation) analizleri; komut farklarının, derleyici optimizasyonlarının ve matematik kütüphanelerinin çok oyunculu fizik motorlarını nasıl rutin biçimde desenkronize ettiğini gösteriyor. Factorio’yu geliştirirken Wube Software, standart sin ve cos fonksiyonlarının Windows, Linux ve macOS arasında hafifçe farklı sonuçlar döndürdüğünü tespit etti; doğru yuvarlamalı bir kütüphane olmadığı için çok oyunculu oyunları senkron tutmak adına kendi yazılımsal trigonometri rutinlerini yazdılar. Açık kaynaklı RTS oyunları da benzer şekilde, işletim sistemleri arasında özdeş hesaplama için STREFLOP gibi özel matematik kütüphanelerini paketledi. ISO C++ Komitesi bu tekrarlanabilirlik sorunlarını P3375 (“Reproducible floating-point results”) gibi önerilerde tartışıyor.
Bu geleneksel çözümlerin hepsinin ortak bir sınırı var. Derleyici bayrakları ve donanım normalizasyonu temel aritmetik işlemlerde (+, −, ×, /, √) tekrarlanabilirlik sağlayabiliyor, ama standart math.h’nin önemli bir bölümünü oluşturan transandantal fonksiyonlarda (sin, cos, exp, log vb.) yetersiz kalıyor. Temel aritmetik işlemler IEEE-754 tarafından kesin biçimde tanımlanmış ve donanımda doğru yuvarlanması zorunlu kılınmışken, transandantal fonksiyonlar neredeyse her zaman yazılımsal yaklaşımlardır ve IEEE-754 bunlar için tarihsel olarak bit düzeyinde kesinlik şart koşmamıştır. Çıktı bitleri de böylece belirli bir kütüphanenin polinom yaklaşımlarının, aralık indirgeme bölünmelerinin veya arama tablosu değerlerinin bir yan ürünü oluyor.
Bir bakımcı fonksiyonu hızlandırmak, ikili boyutu küçültmek veya vektörleştirmek için güncellediği anda en düşük anlamlı bitler birçok girdi için kayıyor. Derleyici bayraklarını dondurmak veya özel arama tabloları kullanmak sizi gelecekteki kütüphane güncellemelerinden korumaz; geriye ya bağımlılıkları hiç güncellememek kalır ya da alt testleri sık sık yenilemek.
Doğru yuvarlama sorunu neden kökünden çözüyor?
IEEE-754 kapsamında bir matematik fonksiyonu tüm standart yuvarlama modlarında (round-to-nearest, round-up, round-down, round-to-zero) doğru yuvarlanmayı garanti ediyorsa, herhangi bir girdi için çıktı bit örüntüsü matematiksel olarak tektir. Tek bir doğru cevap vardır.
Doğruluğu doğru yuvarlama üzerinden çözdüğünüzde kararlılık ve tutarlılık kendiliğinden geliyor. Çıktı bir uygulama detayı değil matematiksel olarak belirlenmiş bir değer olduğu için, kütüphane yazarları gelecek sürümlerde algoritmaları tamamen yeniden yazabilir, optimize edebilir ve vektörleştirebilir; çıktı bitleri değişmez. Fonksiyonlarınız x86-64 ve ARM64’te, Windows ve Linux’ta, veri merkezleri arasında ve kütüphane güncellemeleri boyunca aynı bitleri döndürür. C++23 (P0533R9) ve C++26 (P1383R2) ile gelen constexpr matematik sayesinde bu eşitlik, derleme zamanı değerlendirmesi ile çalışma zamanı yürütmesi arasında da geçerli oluyor.
Table-Maker’s Dilemma ve en kötü durumların bulunması
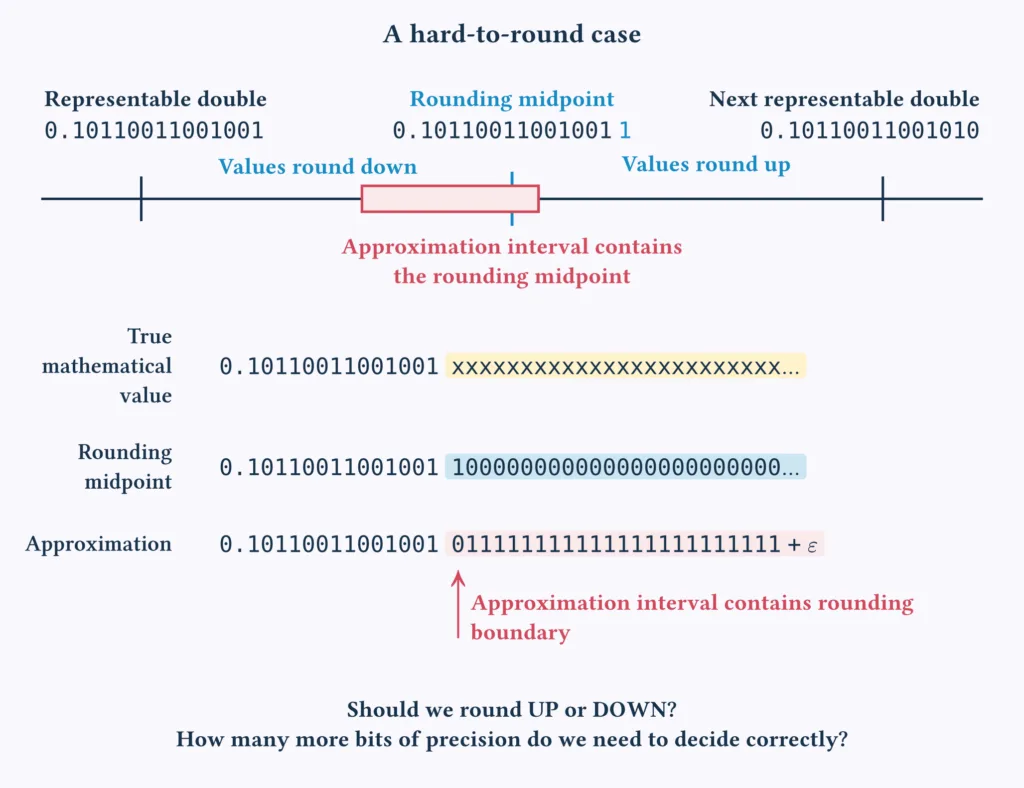
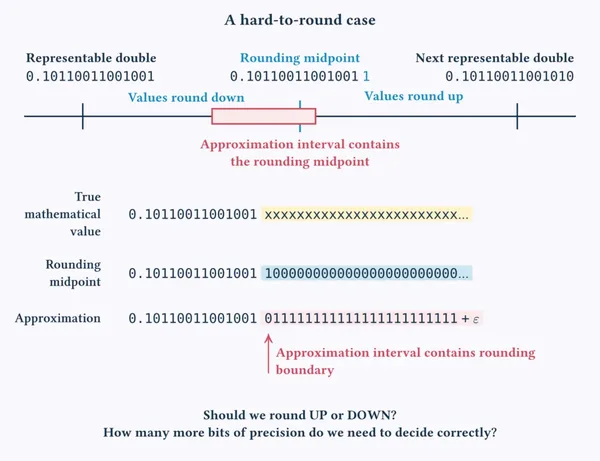
Transandantal fonksiyonlarda doğru yuvarlama, onlarca yıl boyunca Table-Maker’s Dilemma yüzünden üretim sistemleri için fazla yavaş kabul edildi. İkilem şu: y = f(x) transandantal fonksiyonunun bir ŷ yaklaşımını hesaplarken, ŷ‘nin yuvarlanmasının tam matematiksel değer f(x)‘in yuvarlanmasıyla aynı kayan nokta değerini vereceğini garanti etmek için kaç bit ekstra ara hassasiyet gerekir? Gerçek matematiksel sonuç bir yuvarlama orta noktasına (round-to-nearest için) veya temsil edilebilir bir kayan nokta sınırına (yönlü yuvarlama için) çok yakın düşerse, standart hassasiyetteki bir yaklaşım yukarı mı aşağı mı yuvarlanacağını ayırt edemiyor.
Bu alandaki ilk büyük üretim denemesi, 1990’larda Abraham Ziv’in IBM libultim üzerindeki çalışmasıydı; bu kod sonradan glibc’de kullanıldı. Ziv çok aşamalı değerlendirme stratejisini getirdi: önce hızlı bir yaklaşım hesapla, sonuç bir yuvarlama sınırına fazla yakınsa (Ziv’in yuvarlama testi) daha yüksek hassasiyetli yola geç. Gereken azami hassasiyet o dönemde bilinmediğinden, libultim’in yedek yolu 768 bit hassasiyete kadar çıkan keyfi hassasiyetli aritmetik kullanıyordu (slowpow.c, mppow.c gibi iç yardımcılar üzerinden). Programlar bu zor yuvarlanan girdilerden birine denk geldiğinde performans sert biçimde düşüyordu: normal hızlı yoldaki bir pow çağrısı yaklaşık 70 çevrim sürerken, 768 bitlik yedek yol 440.000 çevrime kadar çıkabiliyordu, yani tek bir fonksiyon çağrısında yaklaşık 6.000 kat yavaşlama. Durum glibc Bug 13932 ve Bug 16898 kayıtlarında belgelendi. Öngörülemeyen bu yavaşlamalar sonunda glibc bakımcılarının libultim’i kaldırıp gecikmesi sınırlı, doğru yuvarlanmayan rutinleri tercih etmesine yol açtı; doğru yuvarlama da “üretim için fazla yavaş” ününü buradan edindi.
En kötü durum girdilerinin avı
Bu yavaşlamalardan kaçınmak için aritmetik araştırma topluluğunun temel bir soruyu yanıtlaması gerekiyordu: tüm kayan nokta alanı boyunca en kötü, en zor yuvarlanan girdi hangisi? En kötü durumu bilirseniz gereken azami hassasiyeti de bilirsiniz, sınırlı ve bellek ayırmayan bir yedek yol kurabilirsiniz. Bu girdileri bulmak son derece zordur; çift hassasiyette 2⁶⁴ büyüklüğündeki girdi uzayını kaba kuvvetle taramak uzun süre hesaplama açısından imkansız görüldü.
Atılımı Vincent Lefèvre ve Jean-Michel Muller’in (ENS Lyon / CNRS / Inria bünyesindeki Arénaire / AriC) temel çalışmaları başlattı. “Toward correctly rounded transcendentals” (Lefèvre, Muller, Tisserand, 1998) ve “Worst Cases for Correct Rounding of the Elementary Functions in Double Precision” (Lefèvre, Muller, 2001) gibi öncü yayınlarda, çift hassasiyetli fonksiyonlar için gereken en kötü durum hassasiyetinin sistematik olarak belirlenebileceğini kanıtladılar. Bu çalışmalar CR-LIBM’in yayımlanmasıyla taçlandı ve çift hassasiyetli temel fonksiyonların makul sınırlı ara hassasiyetle doğru yuvarlanabileceği ilk kez gösterilmiş oldu.
Arama son birkaç yılda tamamlandı. LLVM-libc ekibinin Paul Zimmermann ve Vincent Lefèvre ile yakın iş birliği, “Computing hard-to-round cases of sin, cos, tan in double precision” (ARITH 2026) makalesiyle sonuçlandı; standart tek değişkenli çift hassasiyetli matematik fonksiyonlarının tümü için en kötü durum sınırları böylece sistematik olarak arandı ve kanıtlandı. Daha da önemlisi, bu en kötü durum girdileri ve matematiksel sınırlar CORE-MATH proje deposunda açık biçimde barındırılıp sürdürülüyor, dünyadaki kütüphane geliştiricileri için ortak bir doğruluk referansı işlevi görüyor.
2020 civarında LLVM-libc’in matematik kütüphanesi tasarlanırken birbirinden bağımsız birkaç gelişme aynı noktada buluştu. On yılların arama algoritmaları en zor yuvarlanan durumları ortaya koymuş ve çoğu tek değişkenli çift hassasiyetli fonksiyon için 128 bitlik ara hassasiyetin yeterli olduğunu kanıtlamıştı; modern işlemciler ise yerel donanım FMA (Fused Multiply-Add), geniş vektör hatları ve dallanmasız 128 bitlik tamsayı aritmetiğini birkaç çevrimde çalıştırabilecek zengin yazmaç dosyalarına sahipti. Zamanlamanın doğru olduğunu fark eden yalnızca LLVM-libc değildi: aynı dönemde Inria’da Paul Zimmermann liderliğindeki CORE-MATH projesi (açık kaynaklı, doğru yuvarlamalı referans uygulamalar) ve Rutgers Üniversitesi’nde Santosh Nagarakatte liderliğindeki RLIBM projesi (doğru yuvarlama için yeni polinom üretim teknikleri) başladı. LLVM-libc matematik ekibi en baştan itibaren bu iki projeyle aktif iş birliği kurdu, algoritma yaklaşımlarını tartıştı, zor yuvarlanan test vektörlerini paylaştı, paralel uygulamalar geliştirdi ve birbirlerinin uygulamalarını çapraz doğruladı.
Doğru yuvarlama nasıl hızlı olabiliyor?
Geliştiricilerin ilk tepkisi genellikle kuşku oluyor: “Her son biti tam matematiksel değere karşı kontrol ediyorsanız, kütüphaneniz nasıl yavaş olmuyor?” Yanıt, yürütme hattının modern donanımın güçlü yanlarına göre kurgulanmasında.
Bir girdi geldiğinde doğrudan yüksek hassasiyetli matematiğe geçilmiyor. İlk aşama, double-double veya kırpılmış double-double aritmetiği kullanarak dikkatle ayarlanmış hızlı bir Taylor ya da minimax polinom yaklaşımını değerlendiriyor ve 70-106 bit hassasiyet elde ediyor; bu hesap yerel donanım FMA komutlarıyla ciddi biçimde hızlanıyor. Fonksiyonun tanım kümesi, gerekirse kullanılan arama tabloları CPU’nun L1 önbelleğine rahatça sığacak biçimde küçük aralıklara bölünüyor.
Hızlı yol bu double’dan daha yüksek hassasiyetli yaklaşımı hesapladıktan sonra Ziv’in yuvarlama testi uygulanıyor, yani hata aralığının bir yuvarlama sınırı içerip içermediği kontrol ediliyor. Cevap netse (tüm olası girdilerin %99,99’undan fazlasında durum böyle) sonuç hedef hassasiyete yuvarlanıp hemen döndürülüyor. Gecikme ve verim açısından bu hızlı yol, doğru yuvarlanmayan hızlı matematik kütüphanelerine çok benziyor.
Peki hızlı yolun sonuca varamadığı, %0,01’in altındaki o nadir zor girdiler ne oluyor? Azami ara hassasiyetin matematiksel olarak 128 biti hiç aşmadığı kanıtlandığı için ikinci aşamanın keyfi hassasiyetli bir kütüphane çağırmasına veya öbekte (heap) bellek ayırmasına gerek kalmıyor. Bunun yerine, öngörülebilir ve sınırlı çevrim sayısına sahip sabit, dallanmasız 128 bit veya 256 bit tamsayı rutini çalışıyor. Gecikme uçurumu yok.
Optimize etme özgürlüğü
Garantili doğru yuvarlama, matematik kütüphanesi geliştirmenin ekonomisini tamamen değiştiriyor. Tarihsel olarak bakımcılar matematik rutinlerine dokunmaktan kaçınırdı; polinom derecesini değiştirmek veya arama tablosunu küçültmek gibi her ayar çıktı bitlerini kaydırır, alt katmandaki regresyon testlerini kırardı. Doğru yuvarlamayla bu endişe ortadan kalkıyor. Çıktı matematiksel olarak belirlendiği için polinom derecelerini ayarlamak, önbellek ayak izini optimize etmek, hedefe özgü donanım komutlarından (FMA ve SIMD gibi) yararlanmak veya hızlı yolları baştan yazmak serbest hale geliyor.
Kütüphanenin tamamının temiz, standart C++ ile yazılması da derleyici optimize edicilerine kodun tamamını görme imkanı veriyor. Veri akışını gizleyen satır içi assembly veya platforma özgü yapılar olmadığı için modern derleyiciler yardımcı fonksiyonları serbestçe satır içine alabiliyor, komut düzeyi paralelliği artıracak şekilde komut zamanlaması yapabiliyor ve döngüleri farklı mimarilerde otomatik vektörleştirebiliyor.
Doğru yuvarlamalı matematiği üretime taşımak, akademik öncüleri, açık kaynak bakımcılarını ve endüstri ortaklarını kapsayan çok yıllı bir çaba oldu. Yazılım yığınları giderek daha karmaşık ve dağıtık hale gelirken, aynı girdinin her yerde aynı bitleri üretmesi bir lüks olmaktan çıkıp pratik bir ihtiyaca dönüşüyor.
Kaynaklar ve İleri Okuma
- Bringing Correctly Rounded Math to Production with LLVM-libc (Microsoft C++ Team Blog)
- MSVC C++23 constexpr cmath with LLVM-libc
- MSVC’de constexpr cmath ve LLVM-libc: Ne Değişiyor?
- Bruce Dawson — Intel Underestimates Error Bounds by 1.3 quintillion
- x86 komut referansı: FSIN
- Lefèvre & Muller — Worst Cases for Correct Rounding (ACM)
- Random ASCII — Floating-Point Determinism
- Random ASCII — Intermediate Floating-Point Precision
- Glenn Fiedler — Floating Point Determinism
- Forrest Smith — Synchronous RTS Engines and a Tale of Desyncs
- Factorio Friday Facts #52 — kayan nokta ve çok oyunculu senkronizasyon
- STREFLOP kütüphanesi
- P3375R2 — Reproducible floating-point results
- P0533R9 — constexpr for cmath and cstdlib

20+ yıl deneyimli Azure Solutions Architect. Microsoft sertifikalı bulut mimari ve DevOps danışmanı. Azure, yapay zekâ ve bulut teknolojileri üzerine Türkçe teknik içerikler üretiyor.

Yorum gönder