Azure AI Speech LLM 2607: Çok Dilli Doğrulukta Ne Değişti?
Azure AI Speech tarafında LLM Speech modelinin yeni sürümü LLM Speech 2607 duyuruldu. Güncelleme, çok dilli tanımayı ve konuşma ortasında dil değişen kayıtlardaki doğruluğu artırmayı hedefliyor, bir yandan da phrase list (ifade listesi) özelliğini daha sade bir kullanım modeline taşıyor. Microsoft’a göre yeni sürüm servis tarafında otomatik devreye alınıyor; uygulama mimarinizde bir şey değiştirmeniz gerekmiyor.
2607 sürümünde değişenler
Duyuruda modelin Tier 1 ve Tier 2 dillerinde belirgin bir kalite sıçraması sağladığı, HuggingFace OpenASR leaderboard sıralamasında 2. konumda yer aldığı belirtiliyor. Bir önceki 2605 sürümüne kıyasla Microsoft’un kendi iç değerlendirmelerinde öne çıkardığı başlıklar şunlar:
- Karışık dilli ses girdilerinde, yani konuşmanın ortasında dil değiştiğinde tanıma kalitesi iyileşiyor. Çok dilli toplantılar ve çağrı merkezi görüşmeleri gibi senaryolarda doğrudan karşılığı olan bir gelişme.
- Tier 2 ve Tier 3 dil yerellerinde kalite farkının kapatılması hedefleniyor; özellikle büyük/küçük harf kullanımı, noktalama ve sayı/rakam transkripsiyonu daha tutarlı hale geliyor.
- Alan farkındalıklı varlık ve kişi adı tanıma sayesinde isimler, marka adları ve alana özgü teknoloji terimleri daha isabetli yakalanıyor.
- Gecikme tarafında 2605 sürümüne göre 3 kata kadar hızlanma belirtiliyor. Etkileşimli ve gerçek zamanlı senaryolarda yanıt hissini doğrudan etkileyen bir kalem bu.
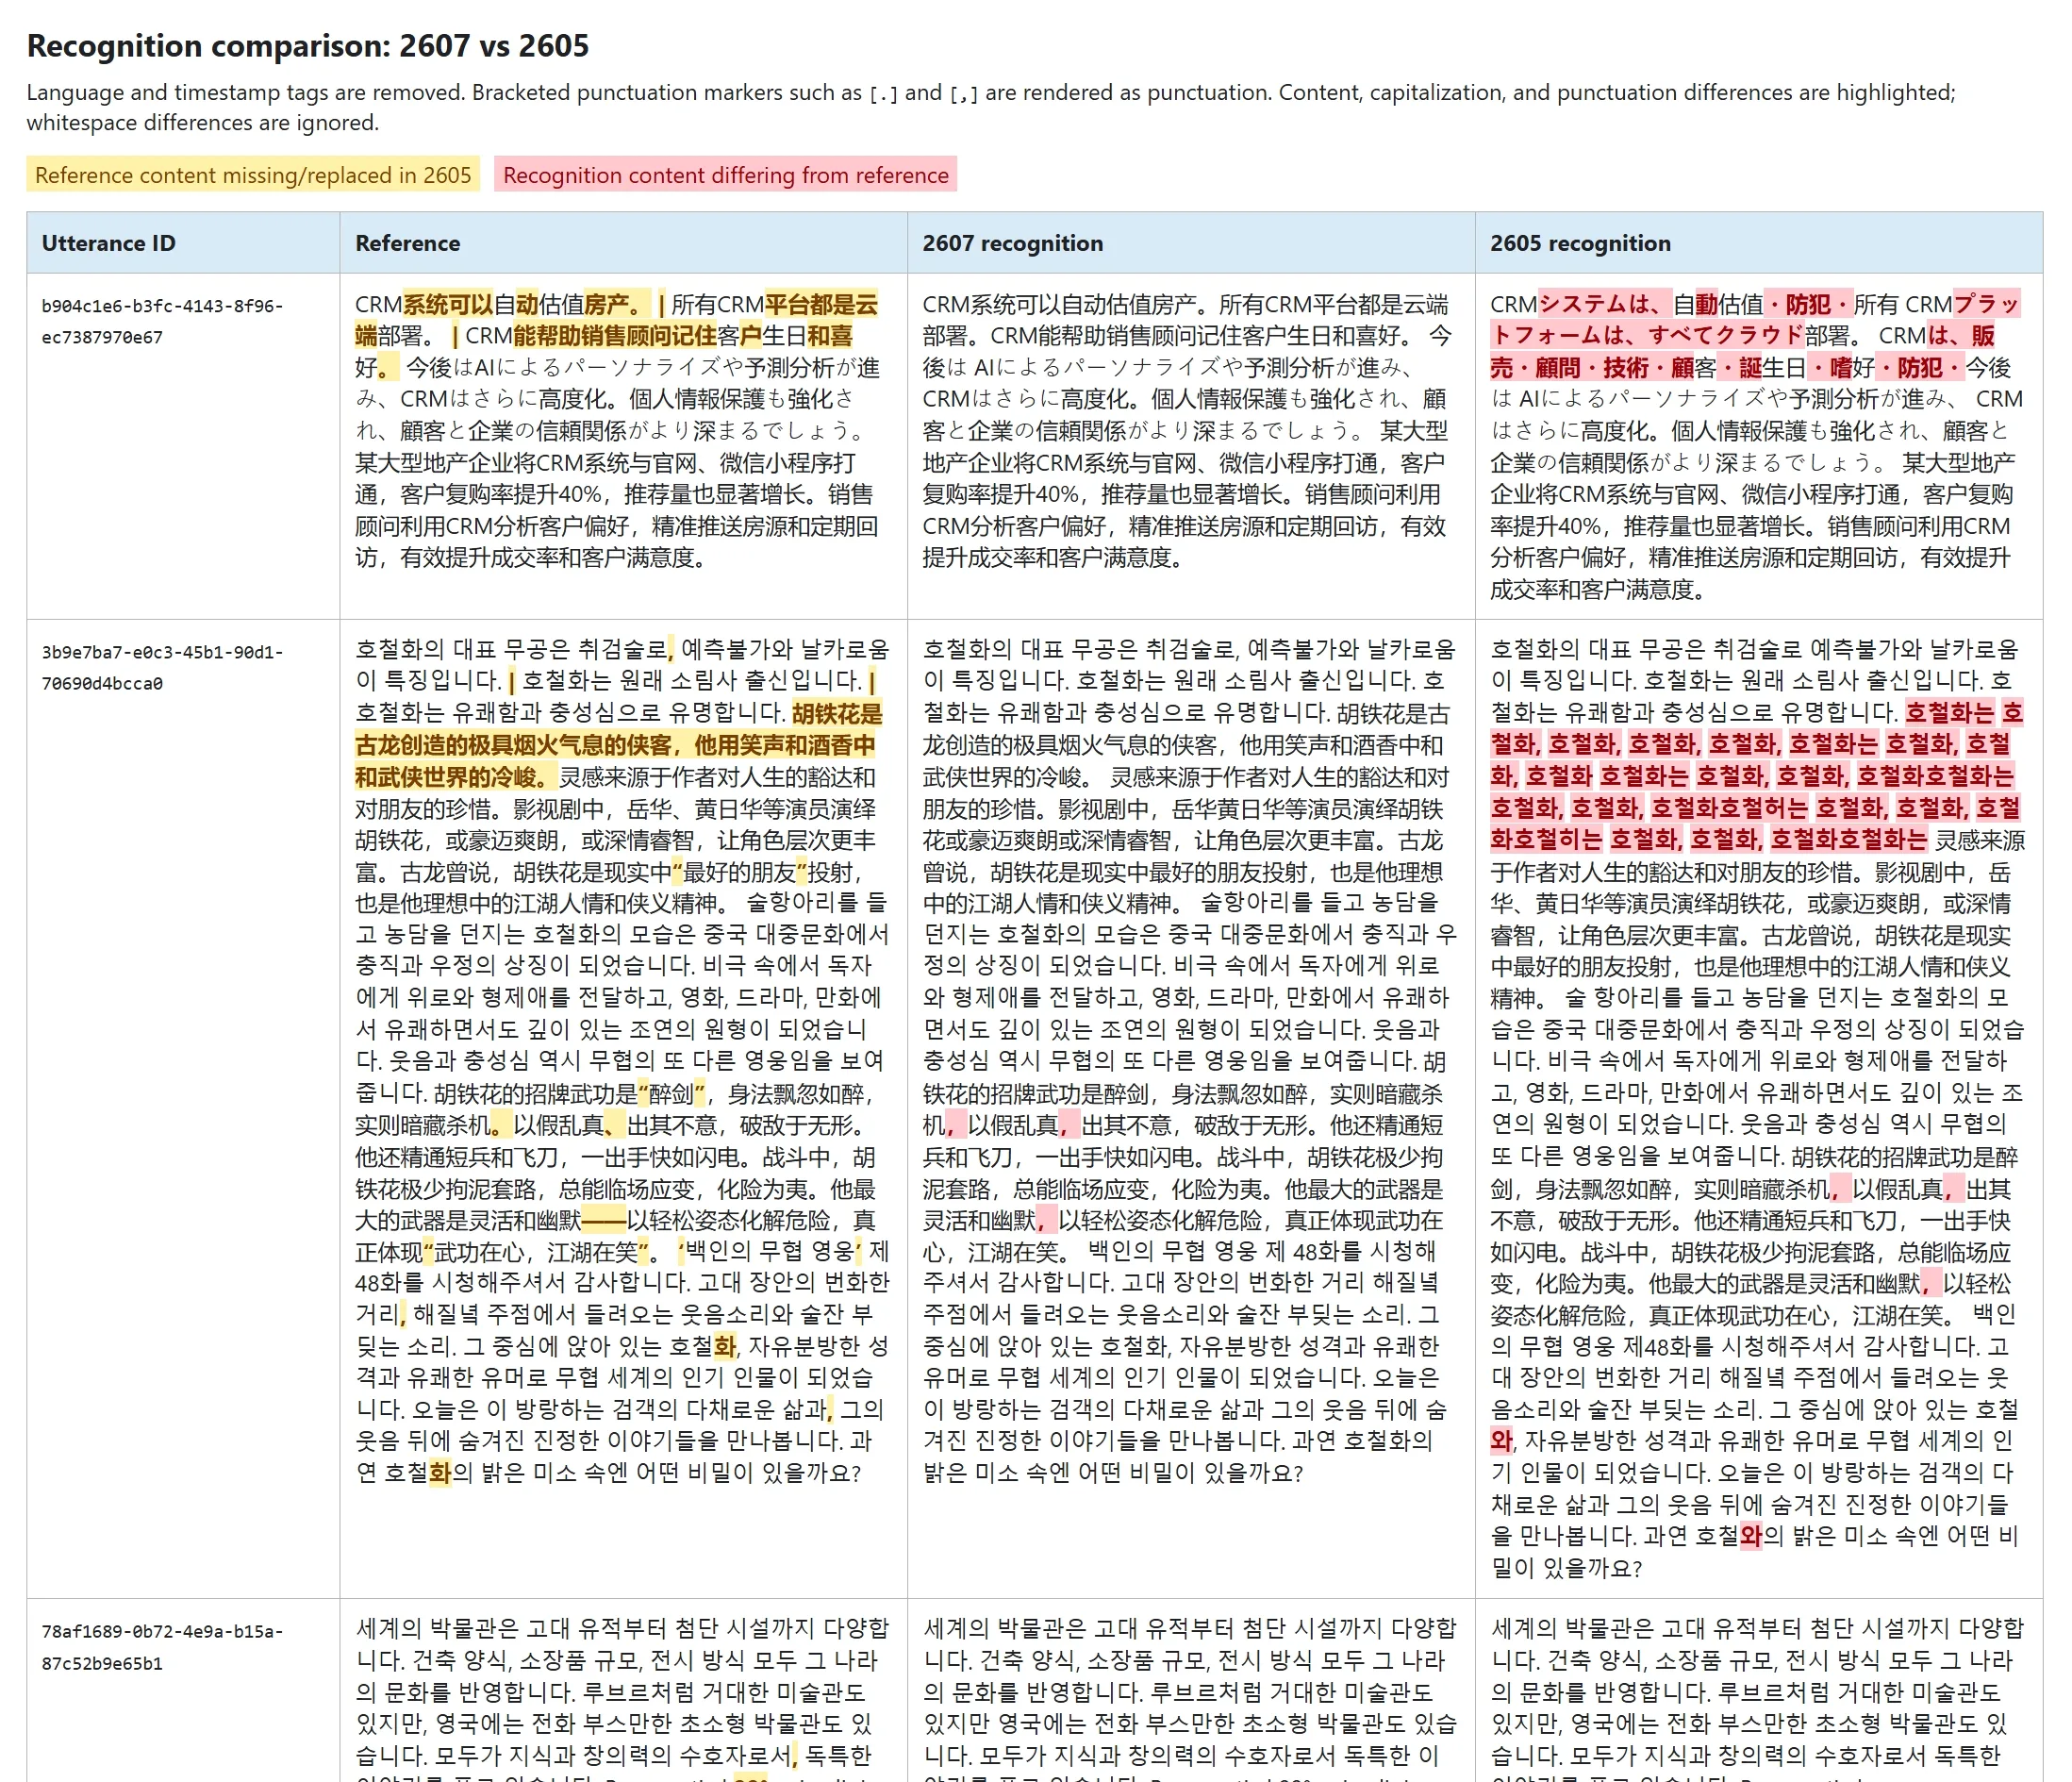
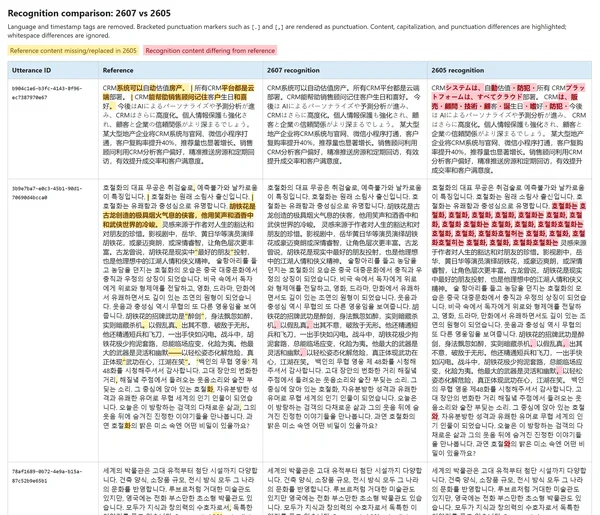
Duyuruda 2605 ile 2607 sürümlerinin iki örnek ses girdisi üzerindeki çıktılarını karşılaştıran bir ekran görüntüsü de paylaşılmış; vurgulanan farklar noktalama ve sayısal transkripsiyon iyileştirmeleri üzerinde yoğunlaşıyor. Rakamsal bir doğruluk ölçümü metinde yok, “ölçülebilir iyileşme” ifadesi iç değerlendirmelere dayanıyor.
Phrase list artık ayrı bir parametre
Konuşma tanıma uygulamalarında en sık karşılaşılan sorunlardan biri, alana özgü sözcük dağarcığının doğru yazıya dökülememesi: ürün adları, teknik terimler, kısaltmalar, şirket isimleri, sektör jargonu. LLM Speech 2607 bu noktada yaklaşımı sadeleştiriyor.
Önceden özel sözcük dağarcığını genel amaçlı bir prompt içine gömmek gerekiyordu, artık phrase list için ayrılmış özel bir alan üzerinden tanıma ipuçları verilebiliyor. Özelleştirme hem daha temiz oluyor hem de üretim ortamında bakımı kolaylaşıyor. Duyuruya göre ifade listeleri 2.000’in üzerinde varlık içerebiliyor, bu da modelin bağlam farkındalığını artırarak kayda değer bir kalite kazancı sağlıyor.
Örnek istek
Duyuruda paylaşılan, phrase list içeren örnek istek şu şekilde:
curl --location 'https://YourResourceName.cognitiveservices.azure.com/speechtotext/transcriptions:transcribe?api-version=2025-10-15' \
--header 'Ocp-Apim-Subscription-Key: YourSpeechResourceKey' \
--form 'audio=@"YourAudioFile"' \
--form 'definition={
"locales": ["en-US"],
"phraseList": {
"phrases": ["Contoso", "Jessie", "Rehaan"]
}
}'
Görüldüğü gibi phraseList, definition gövdesi içinde locales ile aynı seviyede duran bağımsız bir alan. Bu yapı ipuçlarını prompt metninden ayırdığı için sürüm yönetimi ve kod tarafında test edilebilirlik açısından da daha öngörülebilir bir zemin sunuyor.
Phrase list’in öne çıktığı senaryolar
- Kurumsal terminoloji
- Teknik ürün adları
- Sektöre özgü sözcük dağarcığı
- Akronim ve kısaltmalar
- Müşteriye özel tanımlanmış terimler
Erişim yolları
Duyuruda LLM Speech 2607’nin Fast API üzerinden kullanılabildiği belirtiliyor, başlıkta ise hem Fast API hem Real-Time API geçiyor. Yani toplu transkripsiyonda da etkileşimli ses deneyimlerinde de aynı model iyileştirmelerinden yararlanılabiliyor.
Modeli hızlıca denemek isteyenlere Foundry Playground içindeki Azure Speech – Speech to Text bölümü öneriliyor. REST API ve SDK kullanım biçimleri resmi dokümantasyonda yer alıyor; phrase list ile doğruluk artırma konusundaki ayrıntılı rehber de Microsoft Learn belgesinde.
Pratikteki karşılığı
Ses ajanları, toplantı transkripsiyonu, çağrı merkezi çözümleri ya da çevrimiçi toplantı uygulamaları geliştiriyorsanız bu güncellemenin devreye girmesi için ek bir işlem yapmanız gerekmiyor. Yine de değerlendirmeye alınması mantıklı iki başlık var:
- Mevcut prompt tabanlı özelleştirmenizi gözden geçirin. Domain sözlüğünü prompt içine gömdüyseniz, bunu ayrı
phraseListalanına taşımak bakım açısından daha temiz bir yapı sunuyor. - Kendi verinizle doğrulayın. Paylaşılan kalite ve gecikme iyileştirmeleri Microsoft’un iç değerlendirmelerine ve genel bir leaderboard sıralamasına dayanıyor. Türkçe gibi belirli yerellerde beklenen kazanımı görmek için kendi ses örneklerinizle karşılaştırmalı bir ölçüm yapmak en sağlıklı yöntem olacaktır; duyuruda yerel bazlı ayrıntılı metrik verilmiyor.
2607, doğruluk ve gecikme tarafında kademeli ama anlamlı bir iyileştirme getiriyor. Kalıcı değişiklik ise özelleştirme arayüzünde duruyor; phrase list prompt’tan ayrılıp ilk sınıf bir parametre haline gelince üretim uygulamalarında konuşma tanıma davranışını kontrol etmek belirgin şekilde kolaylaşıyor.
Kaynaklar ve İleri Okuma
- Announcing Azure AI Speech LLM 2607: Better Multilingual Accuracy, Easier Customization (Rena Liu, Microsoft Foundry Blog)
- Microsoft Foundry Blog
- Fast transcription API kullanım dokümanı (Microsoft Learn)
- Phrase list ile tanıma doğruluğunu artırma (Microsoft Learn)
- Foundry Playground
- HuggingFace Open ASR Leaderboard
- Microsoft Foundry & Fireworks AI: Açık Yapay Zeka Modelleri

20+ yıl deneyimli Azure Solutions Architect. Microsoft sertifikalı bulut mimari ve DevOps danışmanı. Azure, yapay zekâ ve bulut teknolojileri üzerine Türkçe teknik içerikler üretiyor.


Yorum gönder