SQL Decomposition: T-SQL’de Karmaşıklığı Azaltma
Uygulama kodunda tek bir metodun çok fazla sorumluluk üstlenmesi, kodun okunmasını ve test edilmesini zorlaştırır; güvenli değişiklik yapmayı da güçleştirir. Aynı durum, mantığın veritabanına taşındığı uygulamalar için de geçerlidir. T-SQL, C#’taki sınıf, kalıtım, arayüz ve çok biçimlilik yapılarını aynı biçimde sunmaz. Yine de ayrıştırma, kapsülleme ve açık bağımlılık gibi yazılım geliştirme prensipleri SQL tarafında da uygulanabilir.
SQL decomposition, karmaşık veritabanı mantığını daha küçük, belirli sorumluluklara sahip bileşenlere ayırmaktır. Böylece her bileşenin okunması, test edilmesi, izlenmesi ve değiştirilmesi kolaylaşır. Amaç sistemi daha az yetenekli hale getirmek değil, bileşenlerin her birindeki karmaşıklığı azaltmaktır.
Hibrit arama neden iyi bir örnek?
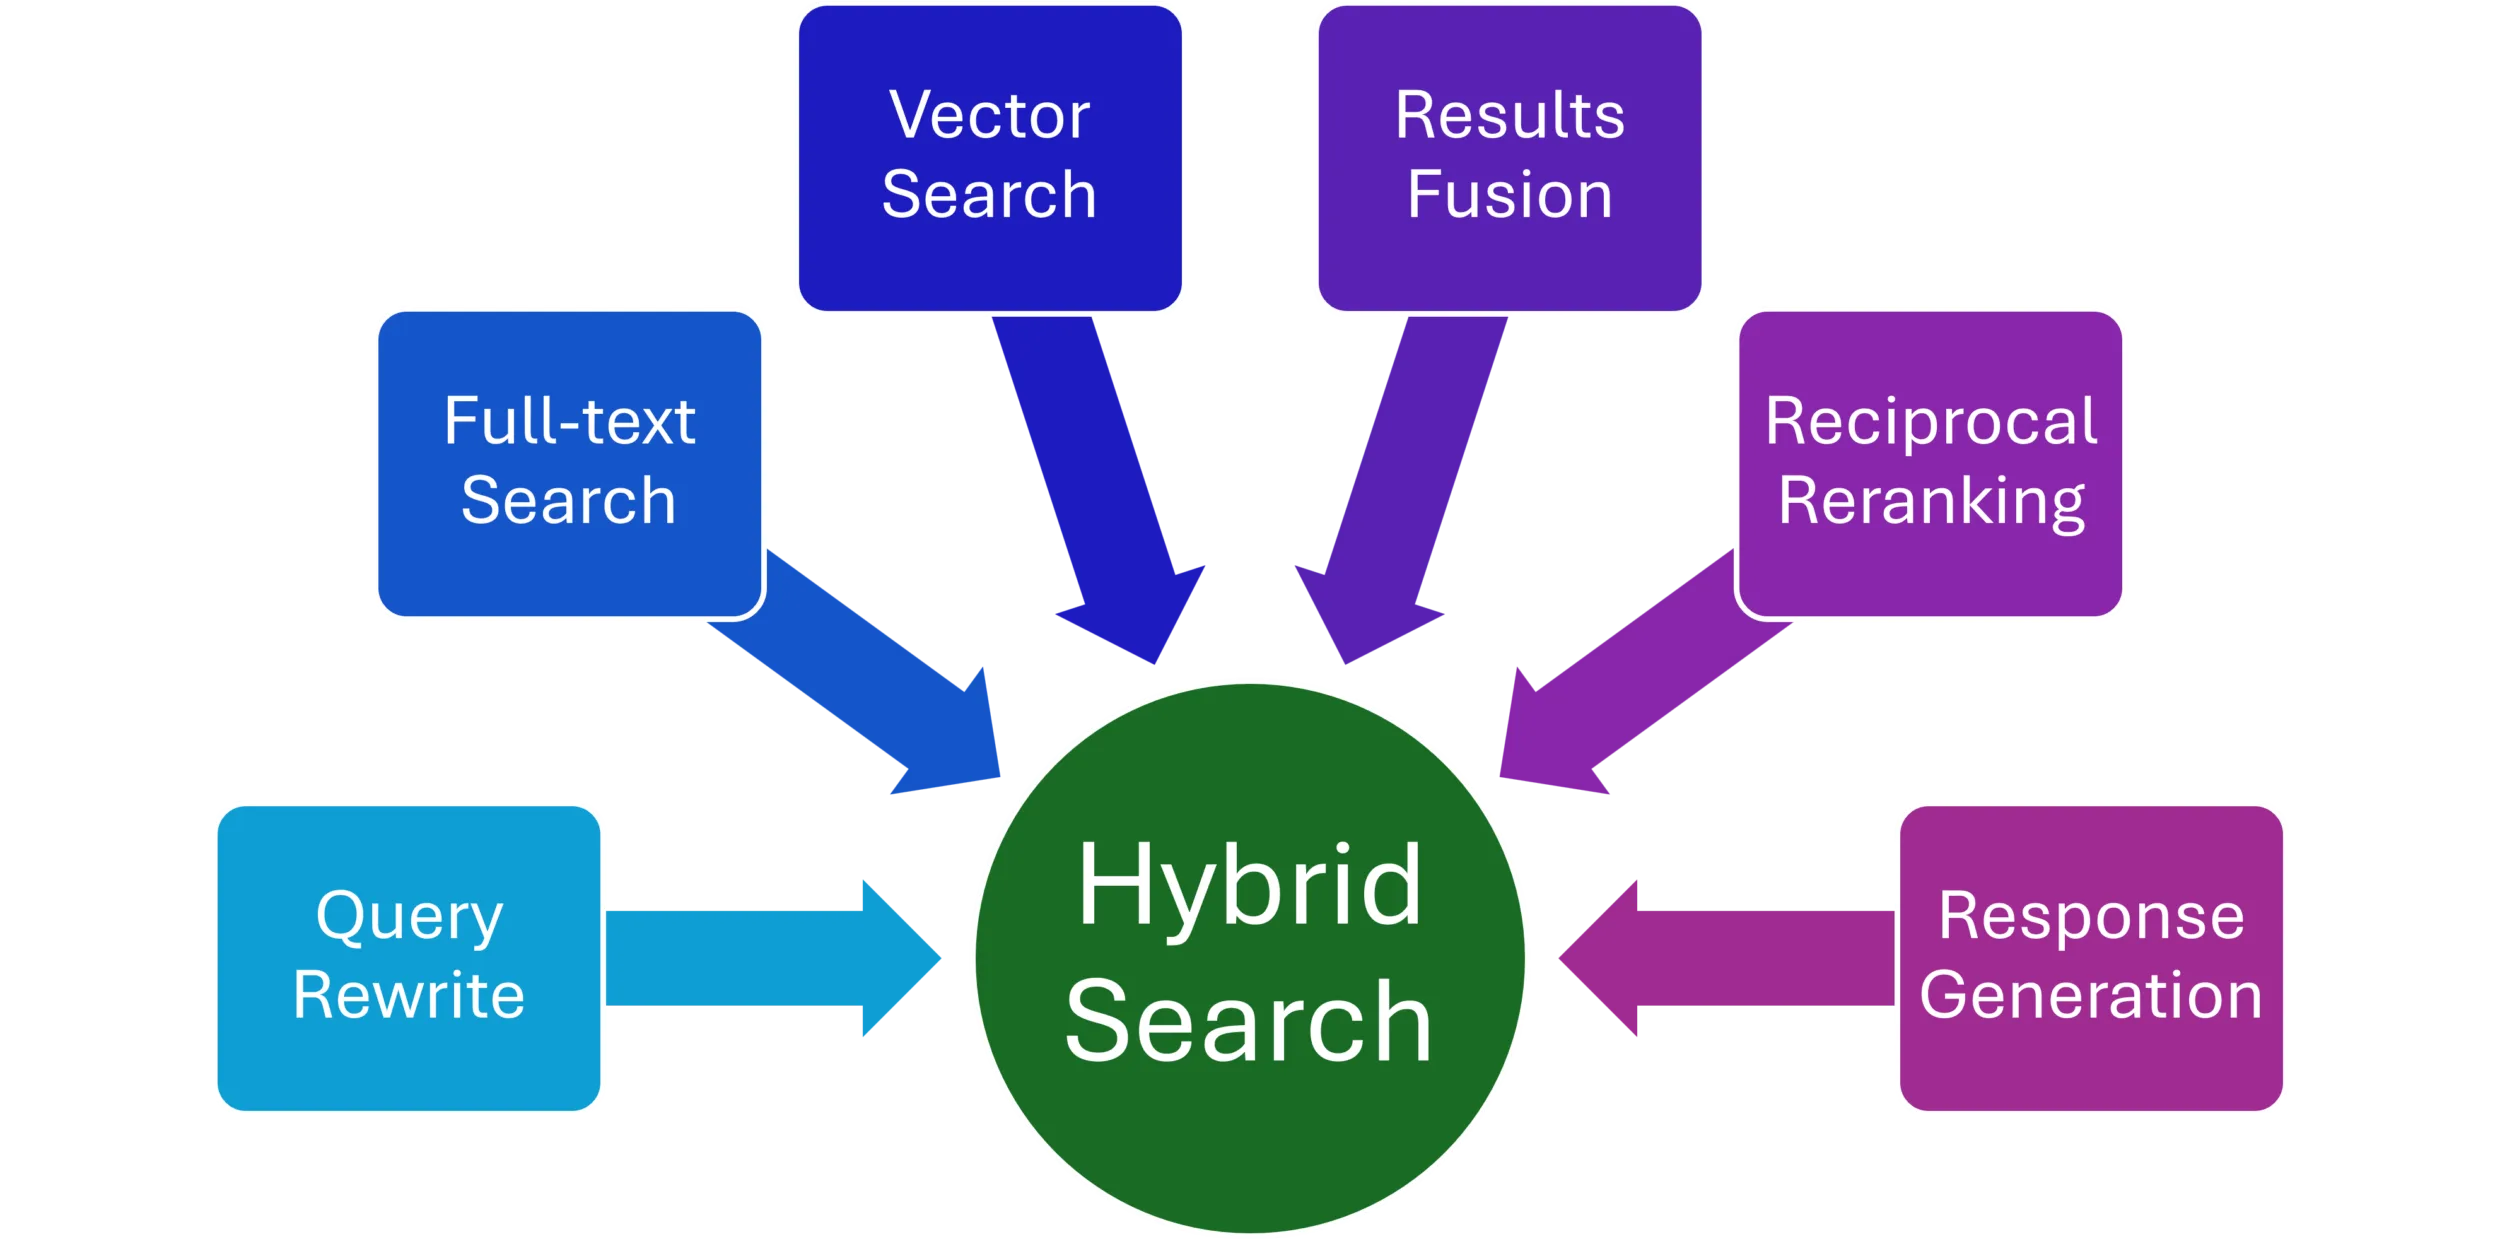
Hibrit arama, genellikle tam metin aramasıyla vektör aramasını birleştirerek sonuç kalitesini artırır. Her yöntem kendi aday sonuçlarını bulur, ardından bu sonuçlar birleştirilip nihai sıralama oluşturulur.
Eksiksiz bir hibrit arama akışında sorgunun yeniden yazılması, embedding üretimi, tam metin araması, vektör araması, sonuçların birleştirilmesi, yeniden sıralama ve yanıt üretimi gibi adımlar bulunabilir. Her adımın sorumluluğu ayrıdır. Tam metin araması vektör aramasına ihtiyaç duymadan çalışabilmeli, vektör araması fusion aşamasından bağımsız test edilebilmeli, fusion da sonuçların nasıl üretildiğini bilmeden bu sonuçları işleyebilmelidir.
Bu akışta tam metin araması, vektör araması ve fusion için ayrı bileşenler oluşturulabilir:
EXEC dbo.ProductSearch_FullText
@Query = @Query,
@TopN = @TopN;
EXEC dbo.ProductSearch_Vector
@QueryVector = @QueryVector,
@TopN = @TopN;
Bileşenler aynı hibrit arama işlemine katılır, ancak birbirlerinin iç çalışma biçimini bilmek zorunda kalmaz.
Ayrıştırma ve kapsülleme ne sağlar?
Tek bir stored procedure zamanla girdi doğrulama, arama, sıralama, sonuç dönüşümü, hata yönetimi ve diğer işlemlerin koordinasyonunu üstlenebilir. Prosedür sistemin fazla sayıda bölümünü tanımaya başladığında okunması ve değiştirilmesi zorlaşır.
Ayrıştırma, bu sorumlulukların arasına sınırlar koyar. Örneğin ProductSearch_FullText yalnızca tam metin aramasına odaklanabilir. Çağıran tarafın FREETEXTTABLE işlemlerini, doğrulama kurallarını veya sıralama hesaplamasını bilmesi gerekmez; girişleri, çıktıları ve beklenen davranışı bilmesi yeterlidir.
CREATE PROC dbo.ProductSearch_FullText
@Query nvarchar(4000),
@TopN int = 20
AS
BEGIN
SELECT TOP (@TopN)
ft.[KEY] AS ProductId,
CAST(ROW_NUMBER() OVER (
ORDER BY ft.[RANK] DESC
) AS int) AS Rank
FROM FREETEXTTABLE(dbo.Product, *, @Query) AS ft
ORDER BY ft.[RANK] DESC;
END;
Bu prosedüre sorgu girer, sıralanmış ürünler çıkar. Sonuçların nasıl bulunduğu sınırın arkasında kalır. İç uygulama değişse bile sözleşme aynı kaldığı sürece orkestrasyon kodunu değiştirmek gerekmeyebilir.
Stateless bileşenlerle açık bağımlılıklar
Buradaki stateless yaklaşım, veritabanı durumunu yok saymaz. Veritabanından veri okumak zaten işlemin temel amacıdır. Kastedilen, global geçici tablolardan, oturum bağlamından, önceki çağrıda oluşturulmuş değerlerden ve başka bir bileşenin daha önce ne yaptığına ilişkin gizli varsayımlardan kaçınmaktır.
Bir bileşenin ihtiyaç duyduğu durum, sınırdan açıkça parametre olarak geçirilmelidir:
CREATE PROC dbo.ProductSearch_Vector
@QueryVector vector(1536),
@TopN int = 20
AS
BEGIN
SELECT TOP (@TopN)
ProductId,
CAST(ROW_NUMBER() OVER (
ORDER BY d.Distance
) AS int) AS Rank
FROM dbo.ProductEmbedding
CROSS APPLY
(
VALUES (
VECTOR_DISTANCE(
'cosine',
Embedding,
@QueryVector
)
)
) AS d(Distance)
ORDER BY d.Distance;
END;
Bu örnekte vektör araması için gereken sorgu vektörü ve döndürülecek aday sayısı açıkça belirtilir. Embedding üretimi bu prosedürün içine gizlenmez; başka bir veritabanı bileşeninde veya uygulama tarafında yapılabilir. Böylece vektör aramasının başlangıç sözleşmesi yalnızca bir vektör almaktır.
SQL Server’ın mimari yapı taşları
SQL geliştiricileri, uygulama geliştiricileriyle tamamen aynı yapı taşlarına sahip değildir. Yine de stored procedure’ler çalıştırılabilir sınırlar, kullanıcı tanımlı tablo türleri yeniden kullanılabilir veri şekilleri, fonksiyonlar ortak mantık, şemalar ise ad alanı ve güvenlik sınırı olarak kullanılabilir. THROW da bileşenlerin beklenen hataları bilinçli biçimde üretmesine yardımcı olur.
Kullanıcı tanımlı tablo türleri
Hibrit arama akışındaki bileşenlerin veri alışverişi için ortak ve öngörülebilir bir şekle ihtiyacı vardır. Kullanıcı tanımlı tablo türü, bu şekli adlandırılmış ve yeniden kullanılabilir bir sözleşmeye dönüştürür:
CREATE TYPE dbo.ProductSearchResult AS TABLE
(
ProductId int NOT NULL,
Rank      int NOT NULL
);
DECLARE @FullText dbo.ProductSearchResult;
DECLARE @Vector dbo.ProductSearchResult;
INSERT INTO @FullText
EXEC dbo.ProductSearch_FullText @Query, @TopN;
INSERT INTO @Vector
EXEC dbo.ProductSearch_Vector @QueryVector, @TopN;Tam metin ve vektör aramasının iç uygulamaları farklı olsa da sonraki aşama aynı veri şekli üzerinden çalışabilir. Burada bir ayrım var: Kullanıcı tanımlı tablo türü, stored procedure sonuç kümesini resmî olarak tiplemez. Prosedürlerin yine de uyumlu sütunlar döndürmesi gerekir. Tür, tablo değişkenleri ve tablo değerli parametreler için mimari içinde yeniden kullanılabilir bir sözleşme sağlar.
Tablo değerli parametreler READONLY durumundadır. Kullanıcı tanımlı tablo türleri sonradan değiştirildiğinde bu işlem tablolara göre daha zahmetli olabileceğinden, onları görece sabit sözleşmeler olarak ele almak gerekir.
Kullanıcı tanımlı fonksiyonlar
Birden fazla bileşende kullanılan anlamlı veya karmaşık mantık, kopyalanmak yerine bir fonksiyonun arkasında toplanabilir. Reciprocal Rank Fusion buna örnektir; sıralamadan bir skor hesaplar:
CREATE FUNCTION dbo.ProductSearch_RrfScore ( @Rank int )
RETURNS TABLE AS
RETURN
(
SELECT 1.0 / (60 + @Rank) AS Score
);SELECT
r.ProductId,
s.Score
FROM @FullText AS r
CROSS APPLY dbo.ProductSearch_RrfScore(r.Rank) AS s;Buradaki amaç her ifadeyi fonksiyona taşımak değildir. Mantığın bir anlamı varsa, yeniden kullanılacaksa veya bağımsız bir sınırı hak edecek kadar karmaşıksa fonksiyon tercih edilebilir. Satır içi tablo değerli fonksiyonlar, küme tabanlı mantıkta kullanılabilir; SQL Server bunları çevreleyen sorgu planına dahil edebilir.
Şemalar da yalnızca ilgili nesneleri gruplamaz, aynı zamanda güvenlik sınırı oluşturur. Örneğin arama bileşenleri bir search şeması altında sunulabilir. Yetkiler, temel tablolara doğrudan erişim yerine gerekli yetenekler üzerinden tanımlanabilir.
Fusion ve hata davranışını sözleşmeye eklemek
Bir bileşenin sözleşmesi başarılı çıktılarla sınırlı değildir, hataları da kapsar. Örneğin geçersiz bir TopN değeri kontrollü biçimde reddedilebilir:
IF @TopN < 1
THROW 51001, 'TopN must be greater than zero.', 1;Fusion aşaması, tam metin ve vektör aramasından gelen iki sonucu bunların nasıl üretildiğini bilmeden birleştirebilir:
CREATE PROC dbo.ProductSearch_Fuse
@FullText dbo.ProductSearchResult READONLY,
@Vector dbo.ProductSearchResult READONLY,
@TopN int = 20
AS
BEGIN
WITH Scores AS
(
SELECT r.ProductId, s.Score
FROM @FullText AS r
CROSS APPLY dbo.ProductSearch_RrfScore(r.Rank) AS s
UNION ALL
SELECT r.ProductId, s.Score
FROM @Vector AS r
CROSS APPLY dbo.ProductSearch_RrfScore(r.Rank) AS s
),
Fused AS
(
SELECT
ProductId,
SUM(Score) AS FusionScore
FROM Scores
GROUP BY ProductId
)
SELECT TOP (@TopN)
ProductId,
FusionScore
FROM Fused
ORDER BY FusionScore DESC;
END;UNION ALL kullanımı bilinçlidir. Yalnızca bir arama yönteminde bulunan ürünler de fusion işlemine katılır. İki yöntemde birden bulunan ürünlerin karşılıklı sıra katkıları toplanır. Bu örnekte son aşama FusionScore döndürür; ara ProductSearchResult şekline dönmesi gerekmez.
Akışı yöneten ince bir prosedür yalnızca orkestrasyon görevini üstlenir:
CREATE PROC dbo.ProductSearch
@Query nvarchar(4000),
@QueryVector vector(1536),
@TopN int = 20
AS
BEGIN
DECLARE @FullText dbo.ProductSearchResult;
DECLARE @Vector   dbo.ProductSearchResult;
INSERT INTO @FullText
EXEC dbo.ProductSearch_FullText @Query, @TopN;
INSERT INTO @Vector
EXEC dbo.ProductSearch_Vector @QueryVector, @TopN;
EXEC dbo.ProductSearch_Fuse
@FullText = @FullText,
@Vector = @Vector,
@TopN = @TopN;
END;SQL’e özgü sınırlamalar ve test yaklaşımı
Veritabanı sınırları, uygulamadaki bir metod çağrısıyla aynı maliyete ve esnekliğe sahip değildir. Örneğin INSERT...EXEC iç içe kullanılamaz. ProductSearch_FullText de aynı yapıyı kullanıyorsa üstteki orkestratör sonuçları aynı yöntemle yakalayamaz. Daha bileştirilebilir akışlarda uygun yaprak işlemler, stored procedure yerine satır içi tablo değerli fonksiyonlar olarak uygulanabilir.
Tablo değişkenleri ve tablo değerli parametreler, geçici tablolarla aynı sütun istatistiklerini sağlamaz. Arama fusion’ında görülen küçük aday kümeleri için bu kabul edilebilir olabilir. Daha büyük ara kümelerde #temp tabloları daha iyi sorgu planları sağlayabilir.
Vektör örneğinde anlaşılabilirlik için VECTOR_DISTANCE kullanılır. Daha büyük veri kümelerinde, yaklaşık arama kabul edilebiliyorsa vektör diziniyle birlikte VECTOR_SEARCH daha uygun bir üretim uygulaması olabilir. Bileşen sınırları doğru kurulduğunda bu tür uygulama değişiklikleri fusion veya diğer aşamalar yeniden tasarlanmadan yapılabilir.
Ayrıştırılmış yapı test sürecini de kolaylaştırır. Tam metin araması tek başına çalıştırılabilir:
EXEC dbo.ProductSearch_FullText
@Query = N'running shoes',
@TopN = 10;
Embedding üretimi, vektör araması ve fusion devreye girmeden her yetenek ayrı ayrı incelenebilir. Hibrit sonuçlar beklenenden farklıysa tam metin sonuçları, vektör sonuçları ve fusion aşaması ayrı ayrı kontrol edilir; sorun hangi sınırda ortaya çıktıysa bulunabilir.
Her şeyi ayrıştırmak da doğru değildir. Küçük bir sorgu için çok sayıda prosedür, tablo türü ve fonksiyon oluşturmak gereksiz mimari yük getirir. Ayrıştırma, sorumluluklar gerçekten bağımsız olduğunda, mantık yeniden kullanılacağında, izole test değer kattığında veya bir bileşenin diğerlerini zorlamadan değişebilmesi gerektiğinde uygulanmalıdır.
İyi SQL tasarımı, SQL’i C#’a benzetmeye çalışmak değildir. Karmaşık mantığa anlamlı sınırlar çizmek, uygulama ayrıntılarını kapsüllemek, bağımlılıkları açıkça geçirmek ve SQL Server’ın prosedür, tür, fonksiyon, şema ve kontrollü hata mekanizmalarından yararlanmaktır. Mimari biraz daha gelişmiş hale gelirken her bileşen daha az karmaşık olur.
Kaynaklar ve İleri Okuma

20+ yıl deneyimli Azure Solutions Architect. Microsoft sertifikalı bulut mimari ve DevOps danışmanı. Azure, yapay zekâ ve bulut teknolojileri üzerine Türkçe teknik içerikler üretiyor.



2 comments