Covering Index ile T-SQL Sorgu Performansı
Aynı sorgunun uygulama içinde defalarca çalıştırılması, veritabanı tarafında ciddi bir yük oluşturabilir. Büyük tablolara karşı çalışan sorguları hızlandırmak için indeks eklemek klasik bir çözümdür ve tabloya erişen herkes bu iyileştirmeden faydalanır. Ancak yalnızca belirli bir sorguyu hedefleyen ve o sorgunun hem filtreleme hem projeksiyon ihtiyaçlarını tek başına karşılayan özel bir tür indeks daha vardır: covering index (kapsayan indeks). Bu yazıda covering index kavramını, ne zaman anlamlı olduğunu ve nasıl tasarlanacağını Jerry Nixon’ın Azure SQL Dev Corner yazısına dayanarak ele alıyorum.
Covering Index Neden “Kapsıyor”?
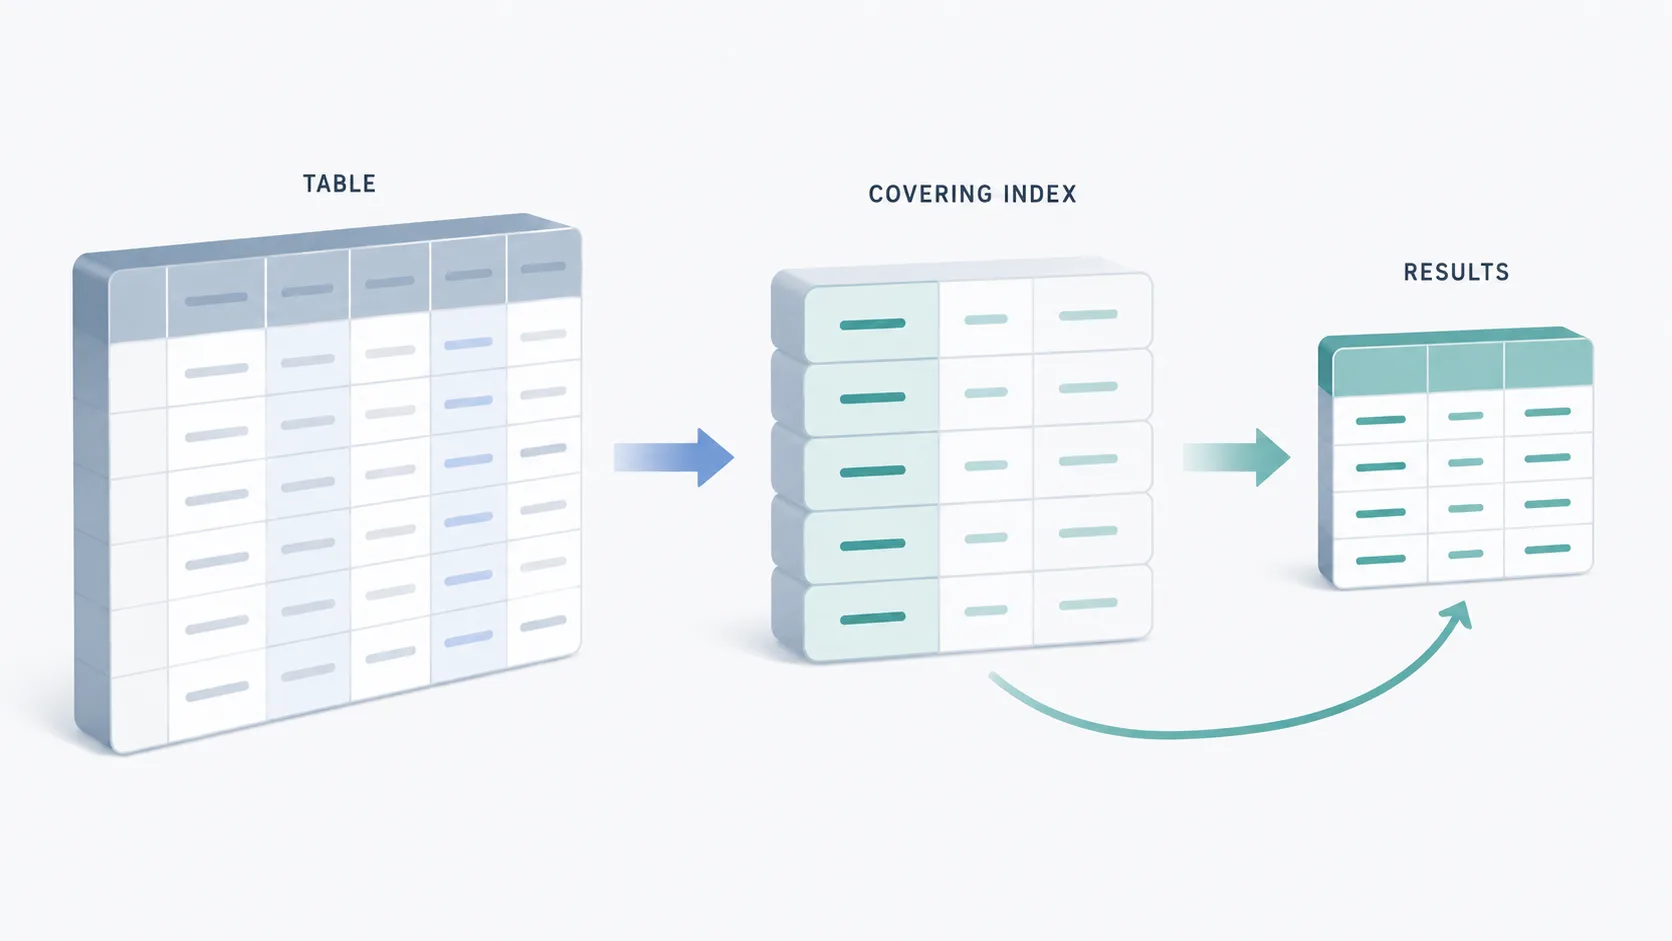
Covering index ismini, hedeflediği sorgunun tüm predicate (WHERE koşulu) ve projection (SELECT sütunları) ihtiyaçlarını karşılamasından alır. Yani sorgunun filtreleme yaptığı sütunlar da, geri döndürdüğü sütunlar da indeksin içinde bulunur. Bu durumda SQL Server, satırı indekste bulur ve ihtiyaç duyulan tüm veriyi yine indeksten döndürebilir; kaynak tabloya dönmek zorunda kalmaz.
Hangi sorgunun bu ayrıcalığı hak ettiğine geliştirici karar verir. İki temel aday vardır: (1) hızlı çalışması kritik olan sorgular ve (2) uygulamada çok sık çalıştırılan sorgular. İndeksler bedava olmadığından her sorgu için ayrı bir covering index oluşturulmaz; ancak doğru sorgu için bu yaklaşım büyük fark yaratabilir.
SQL Server Bir Sorguyu Nasıl İşler?
Örnek olarak müşteri siparişlerini listeleyen tipik bir sorguyu ele alalım:
SELECT
OrderDate,
TotalAmount,
Status
FROM dbo.Orders
WHERE CustomerId = 42;
SQL Server önce doğru tabloyu tespit eder, ardından WHERE koşulundaki predicate’i uygulayarak yalnızca CustomerId = 42 olan satırları tutar. Bu adım milyonlarca satırı gereken birkaç kayda indirebilir. Son olarak SELECT içindeki projeksiyon uygulanır ve yalnızca OrderDate, TotalAmount ve Status döndürülür. CustomerId, satırları bulmak için gereklidir ama sonuç kümesinde yer almaz.
Bu filtreleme adımını hızlandırmak için SQL Server uygun bir indeks arar. İndeks yoksa motor tablodaki her satırı gezmek zorunda kalabilir. Uygun bir indeksle ise doğrudan eşleşen değerlere seek yapılabilir. Aradaki fark, büyük bir kütüphanede yerini bilmediğiniz bir kitabı aramakla, tam raf numarasına gitmek arasındaki farka benzer.
Clustered ve Nonclustered İndeksler
Primary key barındıran tablolarda genellikle bu anahtarı destekleyen bir indeks bulunur. Varsayılan olarak SQL Server bunu bir clustered index olarak oluşturur; tabloda zaten bir clustered index varsa veya farklı belirtilmişse bu değişir.
CREATE CLUSTERED INDEX IX_Orders_OrderId
ON dbo.Orders(OrderId);
Clustered index, tablodaki satırların fiziksel olarak indeks anahtarına göre sıralanmasını sağlar. Ancak Orders tablosunun birincil anahtarı büyük olasılıkla OrderId‘dir, CustomerId değil. Dolayısıyla bu indeks, 42 numaralı müşterinin tüm siparişlerini bulmakta doğrudan yardımcı olmaz.
Nonclustered index ise tabloyu yeniden düzenlemeden, eşleşen satırların nerede olduğunu işaret eden ayrı bir yapıdır:
CREATE NONCLUSTERED INDEX IX_Orders_CustomerId
ON dbo.Orders(CustomerId);
Ek olarak dikkat edilmesi gereken bir nokta: bir sütunun foreign key olması, otomatik olarak bir indekse sahip olduğu anlamına gelmez. CustomerId başka bir tabloya (Customers) referans verse de SQL Server bunun için otomatik indeks oluşturmaz.
Covering Index ve INCLUDE Kullanımı
Covering index’te clustered ya da nonclustered olması ana mesele değildir; asıl mesele sorgudur. Daha net söylersek, sorgunun predicate’leri ve döndürdüğü sütunlar belirleyicidir. Herhangi bir indeks bir sorguya genel anlamda fayda sağlayabilir; ancak covering index, o sorgunun predicate’lerine ve projeksiyon sütunlarına bilinçli olarak uyacak şekilde tasarlanır.
Bu noktada INCLUDE anahtar kelimesi devreye girer. INCLUDE, sütunları indeksin anahtarına dahil etmeden indekse ekler:
CREATE NONCLUSTERED INDEX IX_Orders_CustomerId
ON dbo.Orders(CustomerId)
INCLUDE (OrderDate, TotalAmount, Status);
SQL Server, predicate değerini indekste bulup sorgunun istediği tüm sütunlar da bu indekste yer alıyorsa kaynak tabloya hiç dönmeyebilir. Predicate eşleşmesini indekste bulmak ve zaten oradayken projeksiyon sütunlarını da indeksten döndürmek, sorgu sonuçlarına ulaşmanın en hızlı yollarından biridir.
Covering Index Tasarımı: Adım Adım
Adım 1: Predicate’leri Belirle
Tasarıma sorguyla başlanır. Önce predicate’lerde kullanılan sütunlar tespit edilir. Filtre arayüzleri veya kullanıcı davranışına göre WHERE koşulları dinamik olarak değişiyorsa, kullanılan sütunların üst kümesini ya da temel kullanım senaryolarındaki sütunları belirlemek gerekir. Örnek sorgumuzda bu yalnızca CustomerId‘dir:
CREATE NONCLUSTERED INDEX IX_Orders_CustomerId
ON dbo.Orders(CustomerId);
Parantez içindeki sütunlar indeksin anahtar sütunlarıdır; sıralıdırlar ve SQL Server tarafından eşleşen satırları bulmak için kullanılırlar.
Sütun sırası önemlidir. Eşitlik (equality) predicate’lerini önce, aralık (range) predicate’lerini sonra koymak gerekir; çünkü SQL Server öncelikle baştaki indeks sütunlarını kullanarak aramayı daraltır. INCLUDE ile eklenen sütunların sırası genellikle önemli değildir; projeksiyon sütunlarının sırası da çoğunlukla belirleyici olmaz.
Adım 2: Taşınacak Veriyi Belirle
Tablo verisini indekse kopyalarken, özellikle veri tipleri büyükse dikkatli olmak gerekir. JSON, vektör veya binary veri içeren sütunları INCLUDE etmeden önce iki kez düşünmek gerekir.
Eğer projeksiyon sütunları örnekteki gibi OrderDate, TotalAmount ve Status gibi makul boyuttaysa ve ek depolama maliyetine razıysanız hepsini indekse dahil etmek mantıklıdır:
CREATE NONCLUSTERED INDEX IX_Orders_CustomerId
ON dbo.Orders(CustomerId)
INCLUDE (OrderDate, TotalAmount, Status);
Burada iki önemli uyarı vardır:
- Projeksiyon sütunlarından yalnızca birini bile INCLUDE dışında bırakırsanız SQL Server o eksik değer için kaynak tabloya dönmek zorunda kalabilir. Bu durum, covering index’in temel kazancını büyük ölçüde ortadan kaldırır.
- Diğer uçta, tablodaki tüm sütunları INCLUDE ederseniz kaynak tabloyu neredeyse birebir kopyalamış olursunuz; bu da gereksiz depolama ve bakım maliyeti getirir.
İndeks Bakım Maliyeti ve OLTP Etkisi
İndeksler kendini otomatik olarak günceller. Bir indeks oluşturulduktan sonra, tablodaki her değişiklik ilgili indeksleri de günceller. INSERT, UPDATE veya DELETE işlemleri, etkilenen tüm indeksler güncellenene kadar tamamlanmayabilir. Bu nedenle büyük ya da aşırı sayıda indeks, veritabanının OLTP performansını olumsuz etkileyebilir. Yani her sorgu için covering index yaratmak bir çözüm değil, bir kod kokusudur.
Ne Zaman Covering Index, Ne Zaman Genel İndeks?
Covering index, doğru sorgu için adeta bir gizli sos gibidir; ancak yalnızca bazı sorgular için. Veritabanının geri kalanı ve diğer sorgular için, birden fazla sorguya hizmet edebilecek daha genel indeksler oluşturmak çoğu zaman daha mantıklıdır.
Azure SQL’in otomatik ayarlama (automatic tuning) özelliği, sorgu aktivitesini analiz ederek ek indekslerden fayda sağlayabilecek veya mevcut indekslerde değişiklik gerektirecek sorguları belirler. Aynı analiz manuel olarak da yapılabilir. Yeni bir covering index eklerken yalnızca kâğıt üzerindeki teoriye güvenmemek, üretim boyutundaki tablolarla test etmek ve iş yükünde istenmeyen yan etkiler oluşup oluşmadığını doğrulamak önemlidir.
Sonuçta veritabanı performansının anahtarı; iyi tasarlanmış bir şema, iyi yazılmış sorgular ve uygun indekslerdir. Uygulamada bir “sıcak nokta” tespit ettiğinizde, SQL Server Management Studio içindeki Copilot’a sorguyu yapıştırıp bu sorgu için bir covering index tasarlamasını istemek başlangıç noktası olarak kullanılabilir.
Kaynaklar ve İleri Okuma
- T-SQL Hygiene: Introducing the Covering Index — Jerry Nixon, Azure SQL Dev Blog
- GitHub Copilot in SQL Server Management Studio: Get Started
- Azure SQL Dev Blog

20+ yıl deneyimli Azure Solutions Architect. Microsoft sertifikalı bulut mimari ve DevOps danışmanı. Azure, yapay zekâ ve bulut teknolojileri üzerine Türkçe teknik içerikler üretiyor.



2 comments