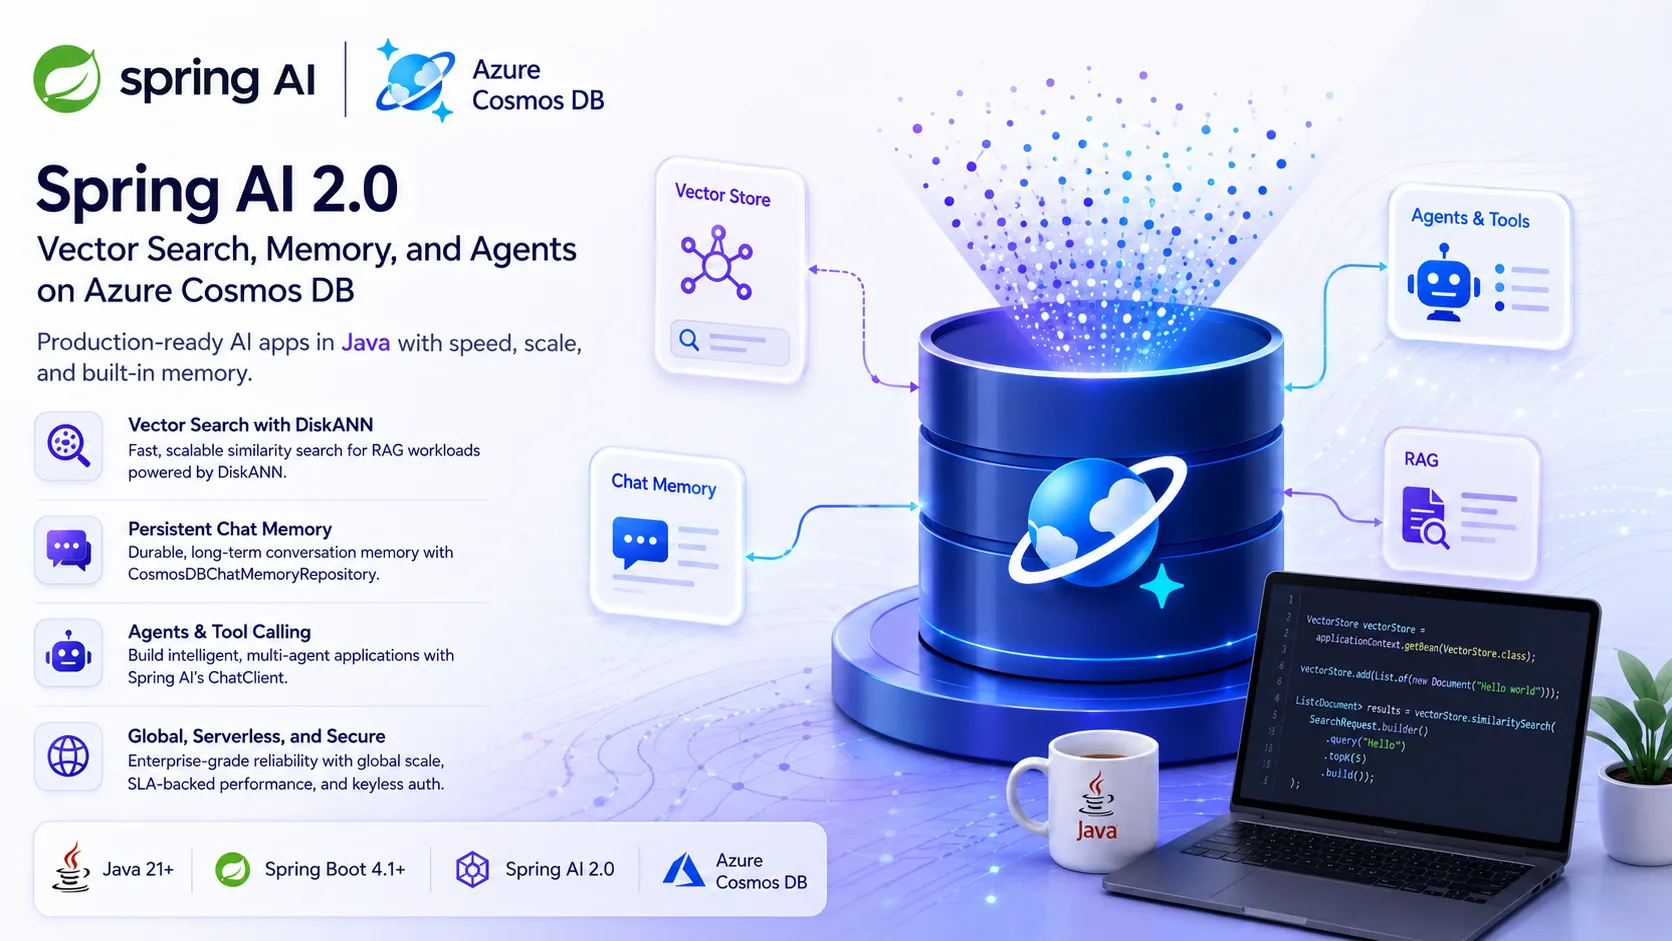

Java ekosistemi AI tarafında biraz ağırdan geliyordu, kabul edelim. Python tarafı LangChain, LlamaIndex derken epey hızlanmışken, Spring dünyasındaki geliştiriciler çoğu zaman ya kendi wrapper’ını yazıyor ya da REST ile Python servislerine çağrı atıyordu. Açık konuşayım, bu iş biraz insanı yoruyordu.
📋 İçindekiler
- Spring AI 2.0’da Aslında — hayır dur, daha doğrusu Ne Değişti?
- Kutudan Çıkan 4 Modül
- Hızlı Bir Başlangıç: Vector Store Kurulumu
- Kalıcı Sohbet Hafizasi: Asıl Is Burada
- Türkiye’deki Şirketler Açısından Durum
- Ajan Senaryoları: Asıl Heyecan Burada
- Pozitif Geçiş Rehberi: Nereden Başlamalı?
- Sıkça Sorulan Sorular
- Kaynaklar ve İleri Okuma
İtiraf edeyim, Neyse, tablo değişti.
Bi saniye — Spring AI 2.0 artık GA oldu ve Azure Cosmos DB de bu çıkışta vendor-maintained bir modül olarak yerini aldı. Yani Microsoft’un Cosmos DB mühendislerinin baktığı, ayrı repo’su olan, kendi release ritmiyle yaşayan entegrasyonlardan söz ediyoruz. Bu ayrıntı küçük görünür ama değil; birazdan nedenini açacağım.
Spring AI 2.0’da Aslında — hayır dur, daha doğrusu Ne Değişti?
Spring AI’ın 1.x serisi kötü değildi, ama tam oturmuş da sayılmazdı. Şimdi 2.0 ile birlikte temel yapı baştan elden geçmiş durumda: Spring Boot 4.1 ve Spring Framework 7 üstüne kurulmuş, JSpecify ile null-safe tarafta baya toparlanmış bir kod tabanı var, Jackson 3 serialization geliyor ve en önemlisi — vector store, chat memory, tool calling ile ChatClient API için artık stabil soyutlamalar var.
Bir dakika — bununla bitmedi.
Bunun pratik karşılığı şu: Bugün Cosmos DB ile çalışan kodunuzu yarın Postgres pgvector’a ya da başka bir vector store’a taşımak isterseniz, uygulamayı baştan yazmanız gerekmiyor. Interface aynı kalıyor, altındaki implementasyon değişiyor (yanlış duymadınız). Mimarı olarak baya iş görüyor bu.
Vendor-maintained ne demek, neden önemli?
Eskiden Spring AI tek parça bir monorepo gibiydi; bütün sağlayıcı entegrasyonları aynı çatı altındaydı. Sorun şuydu: Cosmos DB’ye — kendi adıma konuşayım — yeni bir özellik geldiğinde Spring AI’ın bir sonraki ana sürümünü beklemek zorunda kalıyordunuz. Siz hiç denediniz mi? Şimdi modüller ayrı repolara taşındı, yani Cosmos DB ekibi istediği anda yeni bir feature push edebiliyor.
İşte, bi saniye — Bir de teknik tarafı var tabiî. Cosmos DB’nın RU/s modelini, partition key seçimini, DiskANN indeks parametrelerini en iyi kim biliyor? Ürünün arkasındaki mühendisler, doğal olarak. Generic bir wrapper yazan biri değil (ben de ilk duyduğumda şaşırmıştım). Sahada gördüğüm kadarıyla vendor tarafından yazılmış SDK’lar genelde daha az “weird edge case” çıkarıyor.
Şimdi gelelim işin can alıcı noktasına.
Kutudan Çıkan 4 Modül
Şahsen, Repo’da com.azure.spring.ai group ID’si altında dört modül yayınlanmış (kendi tecrübem). Hepsini ezbere bilmeniz gerekmiyor ama hangisinin ne işe yaradığını bilmek lazım:
| Modül | Işlevi |
|---|---|
spring-ai-azure-cosmos-db-store |
DiskANN destekli vektör deposu |
spring-ai-autoconfigure-vector-store-azure-cosmos-db |
Vektör deposu için sıfır-konfig auto-configuration |
spring-ai-model-chat-memory-repository-cosmos-db |
Kalıcı sohbet hafızası (ChatMemoryRepository) |
spring-ai-autoconfigure-model-chat-memory-repository-cosmos-db |
Chat memory için auto-configuration |
Spring Boot kullananlar bilir, “autoconfigure” paketleri biraz sihir gibi çalışır; application.yml’a birkaç satır yazarsınız, geri kalan çoğu şey kendiliğinden toparlanır. Bu modüller de aynı mantıkta ilerliyor.
DiskANN: Aslında ne yapıyor?
Şahsen, DiskANN, Microsoft Research’ün geliştirdiği yaklaşık en yakın komşu yanı ANN algoritması. Adındaki “Disk” kısmı önemli: indeksin tamamını RAM’de tutmak yerine diski daha verimli kullanabiliyor. HNSW gibi alternatiflerle kıyasladığımda, çok büyük veri setlerinde maliyet/performans dengesi fena durmuyor.
Yani 100 bin embedding’lık bir POC için belki fark etmeyebilirsiniz. 50 milyon dokümanlık kurumsal bir RAG sisteminde HNSW ile yan yana koyunca bellek maliyeti ciddi biçimde düşüyor. Bu da TL bazında Azure faturasına direkt yansıyor, lafı dolandırmaya gerek yok.
Hızlı Bir Başlangıç: Vector Store Kurulumu
Doğrusu, Lafı uzatmadan gerçek koda bakalım. Yeni bir Spring Boot projesinde görüntü şöyle oluyor:
<dependency>
<groupId>com.azure.spring.ai</groupId>
<artifactId>spring-ai-autoconfigure-vector-store-azure-cosmos-db</artifactId>
<version>1.0.0</version>
</dependency>
Sonra application.yml geliyor:
spring:
ai:
vectorstore:
cosmosdb:
endpoint: https://your-account.documents.azure.com:443/
database-name: ai-db
container-name: embeddings
partition-key-path: /tenantId
vector-store-throughput: 1000
metadata-fields: tenantId,docType
Kullanım tarafında işe Spring AI’ın standart VectorStore interface’i devreye giriyor: Daha fazla bilgi için
Kalıcı Sohbet Hafizasi: Asıl Is Burada
Bunu yaşayan biri olarak söyleyeyim, Chatbot yapanlar bilir; kullanıcının önceki mesajlarını hatırlamak göründüğünden daha çetrefilli bir konu. In-memory tutarsanız pod restart olduğunda her şey gidiyor. Redis’e koyarsanız TTL ayarıyla uğraşıyorsunuz. Postgres’e atarsanız sistem şişmeye başlıyor.
CosmosDBChatMemoryRepository, Spring AI’ın native ChatMemoryRepository interface’ını implement ediyor. Yani konuşma geçmişi restart’lardan sağ çıkıyor, oturumlar arasında taşınabiliyor ve conversation ID üzerinden sorgulanabiliyor.
Sahada en sık gördüğüm hata şu: ekipler chat memory’yi sadece “konuşmayı hatırlatma” sanıyor. Oysa düzgün tasarlanmış bir memory katmanı agent’ınızın kim olduğunu, kullanıcının tercihlerini ve geçmiş kararları da tutmalı. Cosmos DB’nın partition key yapısı bu noktada işi baya kolaylaştırıyor.
Çok tenantli senaryoda partition key oyunu
Bunu atlamayayım: Eğer SaaS bir ürün geliştiriyorsanız partition key’i /tenantId olarak ayarlayın. Hem chat memory hem vector store için bunu yapmak mantıklı oluyor. Böylece her tenant’ın verisi fiziksel olarak — kendi adıma konuşayım — ayrı partition’da duruyor, sorgular tek partition’da kalıyor. RU maliyeti aşağı çekiliyor. Yanlış partition key seçimi Cosmos DB tarafında pahalıya patlayan hatalardan biri.
Türkiye’deki Şirketler Açısından Durum
Sıradaki kritik nokta bu işin Türkiye pazarında nasıl durduğu ve hangi şirketler için ne kadar anlamlı olduğu.
Yani, Kurumsal tarafta gördüğüm kadarıyla Java/Spring stack’i hâlâ baskın gidiyor — özellikle bankacılıkta, sigortacılıkta ve büyük perakendede durum böyle (inanın bana). Bu kurumların AI’a geçerken yaşadığı ana problem, mevcut Spring uygulamalarının yanına ayrı bir Python AI servisi koymak zorunda kalmalarıydı. İki runtime, iki CI/CD akışı, iki monitöring seti… işler ister istemez karışıyor.
Ne yalan söyleyeyim, Spring AI 2.0 + Cosmos DB ikilisi bu sıkıntıyı hafifletiyor. Mevcut Spring Boot uygulamanıza dependency olarak ekliyorsunuz; tek runtime, tek deployment modeli kalıyor. Bence Türkiye’deki kurumsal AI adaptasyonu açısından burası önemli bir eşik olabilir.
Hani, Ama küçük bir not düşeyim: Cosmos DB ucuz değil (ilk duyduğumda inanamadım). Küçük bir startup’sanız ve aylık bütçeniz sıkışıksa ilk POC için PostgreSQL + pgvector daha mantıklı olabilir. Spring AI zaten Postgres entegrasyonunu da destekliyor; ihtiyaç büyüyünce Cosmos DB’ye geçersiniz — interface aynı kaldığı için kodu dağıtmıyorsunuz bile (bizzat test ettim). Bu esneklik güzel açıkçası.
Sartup ile enterprise karşılaştırması
- Sartup / 10K-100K embedding: pgvector ya da Cosmos DB serverless. Aylık maliyet birkaç bin TL seviyesinde tutulabilir.
- Orta ölçek / 1M+ embedding, multi-tenant: Cosmos DB autoscale, RU/s 1000-4000 aralığına bakılır. DiskANN burada baya iş görüyor.
- Mega ölçek / 10M+ embedding, global dağıtım: Cosmos DB provisioned throughput + multi-region write daha mantıklı oluyor. Burada Postgres alternatifi pek gerçekçi değil zaten.
Ajan Senaryoları: Asıl Heyecan Burada
Evet, vector search ve memory kendi başına güzel şeyler ama asıl hikâye agent tarafında başlıyor bence. Spring AI 2.0’ın tool calling soyutlamalarını Cosmos DB’nın operasyonel veri tutma kabiliyetiyle birleştirdiğinizde plan-execute-verify döngüsünü düzgün çalıştıran agent’lar ortaya çıkıyor. Bu yaklaşımı daha önce
Bunu biraz açayım.
Mesele sadece bununla da bitmiyor aslında; Microsoft tarafının agent mimarisindeki genel yönelimi de benzer çizgide ilerliyor — bunu Agent Framework ile Claw Mimarisi: İlk Ajanı Üç Adımda Kurmak yazısında detaylandırmıştım zaten (bak şimdi), Spring AI 2.0 yaklaşımı da ona paralel gidiyor diyebilirim.
Agent geliştirirken yaptığım en büyük hatalardan biri vector store ve chat memory için ayrı veritabanları kullanmaktı.
Sonradan fark ettim ki ikisini de aynı Cosmos DB hesabında ama ayrı container’larda tutmak hem operasyon hem maliyet tarafında daha rahat.
Tek backup stratejisi var.
Tek monitöring var.
Tek security boundary var.
İnsan bazen böyle basit şeyi geç anlıyor.
Pozitif Geçiş Rehberi: Nereden Başlamalı?
Eğer “Tamam ikna oldum, başlayacağım” diyorsanız izlemenizi önerdiğim sıra şu:
- Küçük bir POC repo’su açın. Spring Boot 3.4+ ya da 4.1 ile başlayın; eski sürümlerde oyalanmayın. (bence en önemlisi)
- Kosmos DB serverless hesabı oluşturun.“İlk denemeler için provisioned’a gerek yok.”
- Küçük bir veri seti hazırlayın. 20-30 doküman yeterli olur; PDF de olur markdown da olur. — ciddi fark yaratıyor
- Sade bir RAG endpoint’i yazın.. ChatClient + VectorStore retriever ile başlayın.
- Daha sonra memory ekleyin.. Conversation ID üzerinden persist edin.
- Ttool calling’i en sona bırakın.. Agent dönüşümüne oradan girin.
Bunu ters sırayla yaparsanız özellikle en baştan agent’a dalarsanız debugging cehennemine düşersiniz derim ben.
Evet.
Söylüyorum yanı.
Izlemeniz gereken metrikler”
Sıkça Sorulan Sorular
Spring AI 2.0 için hangi Java sürümünü kullanmalıyım?
En az Java 17 lazım, ama açıkçası Java 21’e geçmenizi öneririm. Yani Spring Boot 4.1’in getirdiği iyileştirmelerle birlikte düşününce, modern GC ve virtual thread desteği sayesinde AI workload’larında performans farkı gerçekten hissedilir oluyor.
Spring AI 1.x kodumu 2.0’a taşımak çok mu zorlu?
Aslında o kadar da korkutucu değil. Evet, API değişiklikleri var — ama yıkıcı cinsten değil. ChatClient API daha stabil bir yapıya kavuştu, vector store interface’leri de çok daha temiz hâle geldi. Tecrübeme göre büyük projelerde bile 1-2 günlük bir refactor işi çıkıyor. Hani tek dikkat etmeniz gereken nokta vendor entegrasyonları; onlar için yeni group ID’lere geçmeniz gerekiyor, mesela com.azure.spring.ai gibi.
Cosmos DB yerine Azure AI Search kullansam olmaz mı?
Olur tabiî, ama bence bu bayağı use case’inize bağlı bir karar. Mesela operasyonel veriniz zaten Cosmos DB’deyse ve onunla birlikte semantic search yapmak istiyorsanız, tek veritabanı çözümü olarak Cosmos DB çok daha mantıklı duruyor. Ama senaryonuz saf arama odaklıysa ve hybrid search sizin için kritikse, o zaman AI Search daha güçlü bir seçenek (evet, doğru duydunuz)
Production’a başlarken kaç RU/s ile gitsem iyi olur?
Net bir cevap vermek zor açıkçası. Ama genel önerim şu: vector store container için 1000 RU/s autoscale ile başlayın, chat memory tarafı için 400 RU/s yeterli geliyor. İlk hafta metrikleri izleyip buna göre ayarlarsınız. Autoscale modu,. İlginç, değil mi? Önceden tahmin edemediğiniz yük artışlarında maliyetinizi güzel bir şekilde kontrol altında tutuyor.
Durun, bir saniye.
DiskANN ile HNSW farkını pratikte ne zaman anlarım?
5-10 milyon embedding’in altındaysanız pek hissetmezsiniz açıkçası (ben de ilk duyduğumda şaşırmıştım). O eşiği geçince — kendi adıma konuşayım — DiskANN’in bellek verimliliği somut bir avantaja dönüşüyor. Küçük POC’larda bu fark hani teorik düzeyde kalıyor, bence orası için kafa yormaya değmez.
Kaynaklar ve İleri Okuma
Spring AI 2.0 is GA: Vector Search, Memory, and Agents on Azure Cosmos DB — Microsoft Cosmos DB Blog
Azure Cosmos DB Vector Search Resmî Dokümantasyonu
Spring AI Reference Documentation (kendi tecrübem)
Azure Spring AI Samples — GitHub Repository

20+ yıl deneyimli Azure Solutions Architect. Microsoft sertifikalı bulut mimari ve DevOps danışmanı. Azure, yapay zekâ ve bulut teknolojileri üzerine Türkçe teknik içerikler üretiyor.
İlgili Yazılar

Bu içerik işinize yaradı mı?
Benzer içerikleri kaçırmamak için YouTube ve GitHub hesaplarımı takip edin.
Cosmos DB’nin vendor-maintained olarak gelmesi güzel bir adım, Microsoft’un Spring ekosistemiyle bu kadar yakın çalışması beklenmedik bir gelişmeydi açıkçası. ChatClient soyutlaması da provider değiştirmeyi ciddi kolaylaştırmış, bunu production’da test etmek lazım. Bu arada Azure tarafında kaliteli içerik üretmeye devam ediyorsunuz, geçen Azure DevOps Server yazınız da çok işe yaramıştı: https://www.askinkilic.com.tr/azure-devops-server-haziran-yamalari-sahadan-notlar-ve-gecis/
Cosmos DB entegrasyonunun vendor-maintained olarak gelmesi aslında çok kritik bir detay, bakımı üreticiye bırakmak uzun vadede ciddi fark yaratır. ChatClient soyutlamasının stabil hale gelmesi de beni rahatlattı açıkçası, bir önceki sürümde API değişiklikleri takip etmek biraz yorucuydu. Java tarafı sonunda Python’a yetişiyor gibi hissettiriyor bu alanda.