
Bulut tabanlı kodlama asistanları hızlı sonuç verir ama maliyet birikir, hassas bağlam ağ üzerinden dışarı çıkar, bağlantı koptuğunda akış durur. Foundry Local agentic kodlamayı doğrudan geliştiricinin donanımına taşıyor; kod da bağlam da makinenin dışına çıkmıyor. Bu yazıda Qwen3.8-27B modelini Foundry Local üzerinde yerel olarak çalıştırmayı, GitHub Copilot’a bağlamayı ve bu kurulumun dayandığı optimizasyonları kaynaktaki bilgilerle özetliyorum.
Neden Qwen3.8-27B?
Microsoft birincil optimizasyon hedefi olarak Qwen3.8-27B’yi seçmiş. Gerekçesi, modelin güçlü kodlama yetenekleriyle yüksek performanslı yerel dağıtıma uygun bir boyutu birleştirmesi. 4-bit niceleme (quantization) ile model boyutu yaklaşık 18 GB’a iniyor, yani 24 GB ve üzeri VRAM’e sahip tüketici sınıfı GPU’larda rahat çalışabiliyor.
Kaynakta paylaşılan yayımlanmış benchmark değerleri şöyle:
| Benchmark | Qwen3.8-27B |
|---|---|
| Agentic terminal coding – Terminal Bench 2.1 | 73.0 |
| Agentic coding – SWE-bench Pro | 61.7 |
| Repo seviyesinde kod üretimi – NL2Repo-Bench | 42.3 |
| Agentic coding – DeepSWE 1.1 | 42.2 |
Ölçülen alanlar birbirinden farklı: agentic terminal görevleri, yazılım mühendisliği problemleri ve depo düzeyinde kod üretimi. Bu değerler, modelin bu alanların hepsinde geniş bir yetenek yelpazesi sunduğunu gösteriyor.
ONNX Runtime üzerinde uçtan uca optimizasyon
Foundry Local, ONNX Runtime’ı temel alıp Qwen3.8-27B çıkarım hattını Nvidia GPU’lar üzerinde baştan sona optimize ediyor. Prefill ve decoding aşamaları, bellek yönetimi, uzun bağlam işleme, eşzamanlı istekler: hepsi bu kapsamda. Donanım farkındalıklı optimizasyon yığını üç ana başlıkta toplanıyor.
Daha yüksek çıkarım hızı
Burada DFlash2 spekülatif kod çözme (speculative decoding) kullanılıyor. Teknik, hafif bir “drafter” modelin aynı anda birden fazla token tahmin etmesine dayanıyor ve bellek bant genişliği tavanını aşarak decode verimini belirgin biçimde artırıyor. Buna CUDA graph füzyonları ile en yeni NVIDIA SM121 GPU mimarisine özel ayarlanmış kernel optimizasyonları ekleniyor.
Daha düşük bellek baskısı
Tüketici GPU’larının bellek sınırlarına sığmak için verimli INT4 ağırlık işleme, KV-cache niceleme, embedding bellek paylaşımı ve CPU’ya aktarma (offloading) bir arada kullanılıyor. Yapılandırılabilir, bellek farkındalıklı çıkarım desteği de var; farklı donanım yapılandırmalarında bellek kullanımı ile performans arasında denge kurmanızı sağlıyor.
Uzun bağlam ve paralel çalışma
Modern kodlama akışları, depo genelindeki büyük bağlamların aynı anda birden fazla istek üzerinden işlenmesini gerektiriyor. Sunum altyapısı bunun için prefix caching (daha önce hesaplanmış bağlamın yeniden kullanılması, böylece tekrar eden istemlerin sıfırdan başlamaması) ve eşzamanlı iş yüklerini verimli işleyen continuous batching tekniklerini kullanıyor.
Model optimizasyonunun nasıl yapıldığını incelemek isteyenler için Qwen3.8-27B optimizasyon reçetesi Olive recipes deposunda yayımlanmış durumda.
Kodlama iş yüklerinde ölçülen performans
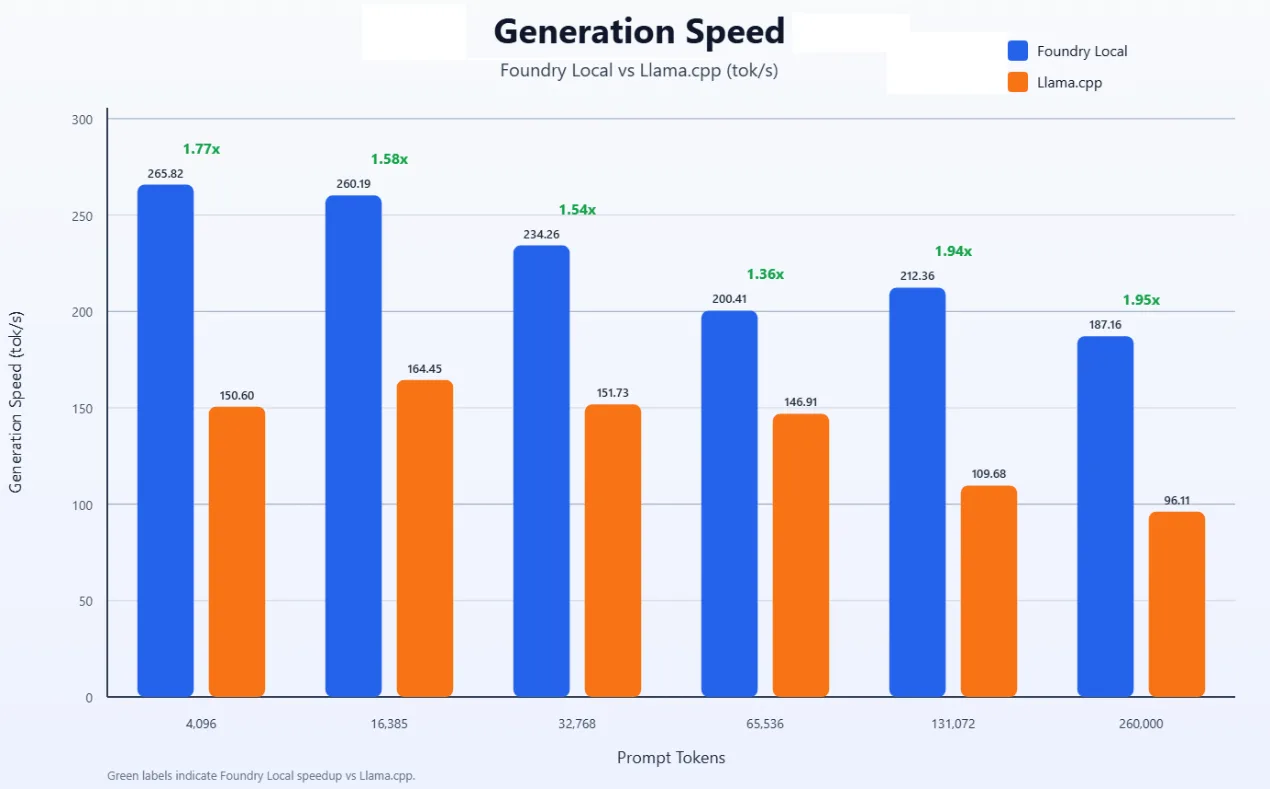
Microsoft ekibi, 4-bit Qwen3.8-27B modeliyle Foundry Local’ı llama.cpp ile karşılaştırmış. Testler iki sistemde yapılmış: 32 GB VRAM’e sahip NVIDIA GeForce RTX 5090 ve 128 GB birleşik belleğe sahip NVIDIA DGX Spark. Değerlendirmede gerçek GitHub issue’larından oluşan bir veri kümesi kullanılmış.
Foundry Local test edilen her istem uzunluğunda daha yüksek üretim hızı sağlamış, aradaki fark özellikle 131K token’ın ötesinde açılmış. Depo ölçeğindeki kodlama akışlarının sürekli performansa ihtiyaç duyduğu bölge de tam olarak burası. Kaynak, karşılaştırmanın sayısal grafiklerini iki ayrı sistem başlığı altında sunuyor; bu yazıda grafiklerdeki ham değerler yer almadığı için yalnızca genel bulguyu aktarıyorum.
Foundry Local’ı GitHub Copilot’a bağlama
En az 24 GB VRAM’e sahip bir NVIDIA GPU’nuz varsa Foundry Local’ı Bring Your Own Key (BYOK) üzerinden GitHub Copilot’a bağlayabilirsiniz. Aşağıdaki adımlar GitHub Copilot uygulamasındaki BYOK akışını temel alıyor; diğer istemcilerde BYOK kullanımı için GitHub’ın kendi dokümantasyonuna bakmak gerekiyor.
Önkoşullar: Bu deneyim Foundry Local CLI 0.13.0 veya üzerini gerektiriyor. NVIDIA GPU ile çalıştırmak için gerekli CUDA ve uyumlu cuDNN runtime’larını ayrıca kurmanız gerekiyor, Foundry Local bu bağımlılıkları indirmiyor. Runtime kütüphane yollarının doğru yapılandırıldığından da emin olun; Windows’ta DLL dizinlerini PATH‘e eklemeniz gerekiyor. Platforma özgü runtime gereksinimleri ve kurulum adımları sürüm notlarında yer alıyor.
1. CLI kurulumu ve sürüm doğrulaması
winget install Microsoft.FoundryLocal
foundry --version
Sürüm komutu 0.13.0 veya üzerini raporlamalı. PATH güncellendiğinde Foundry Local zaten çalışıyorsa, devam etmeden önce yeni bir terminalde foundry server restart komutunu çalıştırın.
2. Modeli yükleyin ve API uç noktasını alın
foundry model load qwen3.8-27b
foundry server status
foundry model load, model daha önce indirilmediyse indirme işlemini başlatır. Uç nokta adresini kendi makinenizde foundry server status çıktısından alın, dokümantasyondaki ekran görüntüsünde görünen port numarasını kopyalamayın.
3. Copilot tarafında sağlayıcıyı tanımlayın
- GitHub Copilot uygulamasında Settings bölümünü açın.
- Model providers → Add provider yolunu izleyip Foundry Local seçeneğini seçin.
- Bir önceki adımda aldığınız API uç noktasını Base URL alanına girin.
- Browse Catalog içinde Qwen3.8-27B’yi arayıp ekleyerek kurulumu tamamlayın.
4. Modeli seçin
Model sağlayıcısını Foundry Local’a geçirin, sonra GitHub Copilot model seçicisinden Qwen3.8-27B’yi seçin. Bu noktadan sonra kodlama akışınız kendi cihazınızda çalışıyor.
Yerel mi, bulut mu? Hibrit yaklaşım
Kaynak önemli bir sınırı açıkça belirtiyor: Yerel modeller daha küçük oldukları için gelişmiş bulut modellerine kıyasla sınırlı muhakeme yeteneğine sahip olabilir. Karmaşık ve yüksek muhakeme gerektiren görevlerde bulut modelleri hala güçlü bir seçenek. Yerel modeller ise günlük kodlama işlerini ve hedeflenmiş alt görevleri verimli şekilde üstlenebiliyor. Pratikte bu, iki tarafı bir arada kullanan esnek bir hibrit iş akışı anlamına geliyor.
Yol haritasında ne var?
Ekibin paylaştığı sonraki adımlar şunlar:
- Qwen3.8-27B desteğinin Mac ve AMD GPU dahil daha fazla cihaza genişletilmesi
- Kodlama için optimize edilmiş yerel model yelpazesinin büyütülmesi
- Foundry Local ile GitHub Copilot entegrasyonunun daha sorunsuz bir yerel kodlama deneyimi için derinleştirilmesi
Foundry Local ve Qwen3.8-27B ikilisi öngörülebilir çıkarım maliyeti, daha yüksek gizlilik ve çevrimdışı çalışabilme özgürlüğü sunuyor; halihazırda kullandığınız bulut modellerinin yanında duran bir seçenek olarak konumlanıyor.
Kaynaklar ve İleri Okuma
- devblogs.microsoft.com
- devblogs.microsoft.com
- devblogs.microsoft.com
- devblogs.microsoft.com
- devblogs.microsoft.com
- devblogs.microsoft.com
- Bring Agentic Coding On-Device with Foundry Local — Microsoft Foundry Blog (orijinal yazı)
- Foundry Local dokümantasyonu: SDK ve CLI referansı
- Foundry Local CLI 0.13.0 sürüm notları
- GitHub Copilot Bring Your Own Key (BYOK) dokümantasyonu
- Qwen3.8-27B model kartı (Hugging Face)
- Qwen3.8-27B CUDA optimizasyon reçetesi (olive-recipes)
- ONNX Runtime GenAI deposu
- GitHub Copilot Local Sandbox ile ajan komutlarını sınırlama

20+ yıl deneyimli Azure Solutions Architect. Microsoft sertifikalı bulut mimari ve DevOps danışmanı. Azure, yapay zekâ ve bulut teknolojileri üzerine Türkçe teknik içerikler üretiyor.