Microsoft SQL Bağlantıları: PostgreSQL’den Ne Değişir
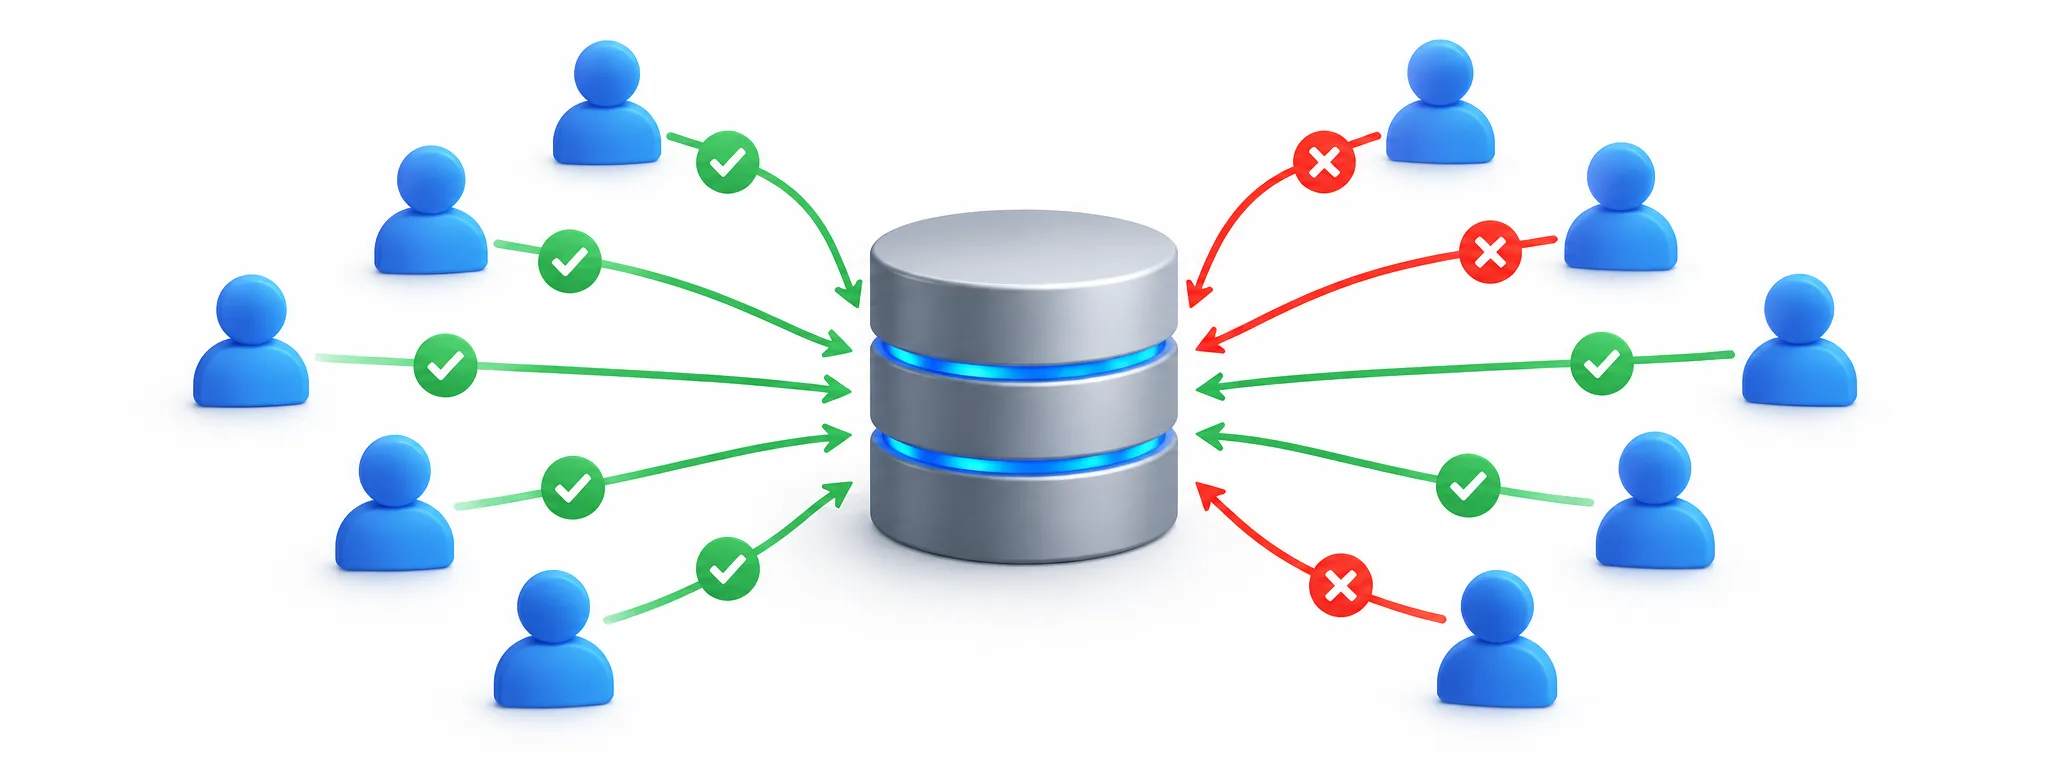
PostgreSQL’den Microsoft SQL’e geçen bir geliştiricinin ilk fark ettiği şeylerden biri, bağlantı yönetiminin artık mimarinin merkezinde durmaması. Jerry Nixon’ın “PostgreSQL to SQL Field Notes” serisinin bağlantılar bölümü tam da bunu anlatıyor. İki motor SQL standardını paylaşıyor, bağlantıların sunucuda nasıl karşılandığı ise ayrışıyor. Bu yazıda PostgreSQL’de bağlantı maliyetinin mimariyi neden şekillendirdiğini ve Microsoft SQL’in worker tabanlı modelinin uygulama tasarımında neyi serbest bıraktığını özetliyorum.
Not: Microsoft dokümantasyonunda ve bu bağlamda “SQL” ifadesi, Microsoft’un SQL standardı türevi olan ve tüm Microsoft SQL veritabanı motorlarında paylaşılan T-SQL (Transact-SQL) anlamına geliyor.
PostgreSQL’de bağlantı neden pahalı bir kaynaktır?
.NET tarafından PostgreSQL’e bağlanmak kod seviyesinde oldukça basit görünür:
using Npgsql;
using var connection = new NpgsqlConnection(connectionString);
connection.Open();
// Use the connection
Bu basitliğin arkasında, geliştiricinin sürekli aklında tuttuğu bir yük var. PostgreSQL her bağlantı için bir işletim sistemi süreci kullanır. Süreçlerin kendi özel belleği ve yürütme durumu vardır, üstüne işletim sistemi zamanlaması ve bağlam değiştirme (context switching) maliyeti biner. Bağlantı başına maliyet şu formüle iniyor:
İşlemci + Bellek + Ek yük = Bağlantı maliyeti
Sonuçta, performans bozulmaya başlamadan önce bir sunucunun kaldırabileceği bağlantı sayısında pratik bir tavan oluşur. PostgreSQL’in kendi dokümantasyonu, varsayılan max_connections değerinin tipik olarak yalnızca 100 olduğunu belirtiyor. Limiti yükseltmek mümkün, ama PostgreSQL bu durumda paylaşılan bellek dahil daha fazla kaynak ayırır. Motor bağlantıyı, dikkatle yönetilmesi gereken bir kaynak olarak kurgulamış.
Sürekli gözetim: izleme, havuzlama ve sonlandırma
Uzun ömürlü tek bir PostgreSQL bağlantısı başlı başına sorun değil, sorun bunların sayıca birikmesi. Boşta (idle) bağlantılar bile kaynak tüketmeye devam eder, boşta bekleyen transaction’lar ise daha ciddi sonuçlar doğurur.
PG tarafında oturumları, durumlarını, çalışan sorguları ve transaction sürelerini izlemek için yerleşik sistem görünümü kullanılır:
SELECT *
FROM pg_stat_activity;
Buradaki amaç active, idle ve özellikle idle in transaction durumundaki bağlantıları ayırt etmek. Sunucuya ulaşan fiziksel bağlantı sayısını azaltmak için popüler bağlantı havuzlayıcı PgBouncer devreye alınabilir. Sorunlu bağlantıların yönetiminde ise bilinen komutlar devrede:
pg_cancel_backend()pg_terminate_backend()
Bu araç seti sürekli bir dikkat ister; bağlantılar düzgün yönetiliyor mu, boşta transaction birikiyor mu diye bakmak gerekir. Küçük ölçekte veritabanını “kur ve unut” yaklaşımıyla bırakabilirsiniz, ama güvenilirlik ve ölçek konuşulmaya başlandığında bağlantı ve transaction yönetimi ana gündem maddesine dönüşür.
Bağlantı tükenmesi ve küme genelindeki limit
Önemli bir ayrıntı var. PostgreSQL’de bağlantı limitleri veritabanı düzeyinde değil, küme genelinde tanımlı. Her bağlantı ayrı bir backend sürecine karşılık gelir ve belirleyici olan, sunucunun sonlu kapasitesidir. Bir veritabanını taşıdığınızda bağlantı hesabını aynı sunucudaki diğer tüm veritabanlarını da kapsayacak şekilde yapmak zorundasınız. Tipik varsayılan olan 100 eşzamanlı bağlantı, o sunucudaki veritabanları arasında paylaşılır. Limiti yükseltebilirsiniz, bu da doğrudan kaynak ihtiyacını artırır.
Motorun davranışı, geliştiricinin davranışını belirliyor
Bu model, uygulama ve agent tasarlayan geliştiriciyi bağlantı maliyetini mimariye yansıtmaya zorlar. Pratikte karşılığı genellikle eşzamanlı bağlantı sayısını sınırlamak ve transaction’ları kısa tutmak oluyor.
Uzun süren transaction’lar eski satır sürümlerinin tutulmasına yol açar, VACUUM temizliğini engeller, tablo şişmesini (bloat) artırır, transaction ID wraparound baskısına katkıda bulunur. PostgreSQL’in bağlantı modeli bu yüzden uygulamaların nasıl tasarlanıp yönetileceğini, özellikle bağlantı ve transaction yönetimi tarafında belirgin biçimde yönlendirir. Uygulamanız bu kalıbın dışına çıkmak istediğinde, bakım maliyetini artırabilecek ek stratejiler devreye sokmanız gerekir.
Microsoft SQL’de worker tabanlı mimari
Microsoft SQL tarafında istemci kodu neredeyse aynı görünür:
using Microsoft.Data.SqlClient;
using var connection = new SqlConnection(connectionString);
connection.Open();
// Use the connection
Kod aynı, fark motorun altında. Microsoft SQL’de bir bağlantı, ömrü boyunca ayrı bir işletim sistemi süreciyle ya da kendisine tahsis edilmiş bir worker ile bire bir eşlenmez. Motor, iş yürütülmesi gerektiğinde worker atar, iş bittiğinde bu kaynaklar başka isteklerin kullanımına açılır. Boşta duran bağlantılar da bu yüzden görece az sunucu kaynağı tüketir.
Bağlantı havuzlamasını ADO.NET tipik olarak otomatik yönetir. Bu da ayrıntılı bağlantı yönetimi stratejileri kurmadan uygulamayı ölçeklendirmeyi kolaylaştırıyor.
Kaynağın öne çıkardığı başlıklar:
- Microsoft SQL, örnek (instance) başına 32.767 eşzamanlı kullanıcı bağlantısına kadar destek verir.
- Aynı şekilde örnek başına 32.767 veritabanına kadar destek sunar.
- Her bağlantı, sunucu kaynak tüketiminde orantılı bir artış anlamına gelmez.
- Bağlantı havuzlaması, yeni fiziksel bağlantı kurmanın ek yükünü daha da azaltır.
- Uygulamalar, kendilerine uygun tempoda bağlantı açıp kapatabilir.
Bu rakamlar mimari farkı göstermek için; gerçek pratik kapasite iş yüküne, donanıma, servis katmanına ve diğer kaynaklara bağlı. Yine de tablo net, Microsoft SQL küçük bir adanmış backend süreci havuzu etrafında tasarlanmamış.
Oturumlar hala görünür: izleme ve KILL
PostgreSQL gibi Microsoft SQL’de de bağlantı ve oturum kavramları var. Aradaki ayrım, her bağlantıya ayrı bir backend sürecinin adanmaması; bu da bağlantı sayısını kaynak tüketiminden ayrıştırıyor. Bir oturum iş yürütmeye başladığında motor gereken worker ve belleği dinamik olarak atar, iş tamamlandığında bu kaynaklar başka oturumlar için serbest kalır. Bağlantı, adanmış bir süreci gereksiz yere meşgul etmeden açık kalabilir.
Kontrolü elden bırakmak zorunda değilsiniz, ihtiyaç duyacağınız yönetim görünümleri yerinde duruyor:
SELECT *
FROM sys.dm_exec_sessions
WHERE is_user_process = 1;
Örneğin desteklediği eşzamanlı kullanıcı bağlantısı sayısını doğrudan motora sorabilirsiniz:
SELECT @@MAX_CONNECTIONS AS MaxConnections;
Normal yapılandırılmış bir SQL örneğinde yanıt 32767 olur.
Bir oturumu sonlandırmanız gerekiyorsa session ID ile KILL kullanılır:
KILL <session_id>;
Yeni varsayılan: havuzlamaya güvenmek
Microsoft SQL’de bağlantıları izlemek ve oturum öldürmek, rutin bir bağlantı yönetimi stratejisi olmaktan çok son çaredir. Belirli bir gerekçe olmadan bağlantı sayısını elle yönetmeye çalışmak kaynakta açıkça antipattern diye niteleniyor. Çoğu uygulama için doğru yaklaşım, işi SQL’e ve istemci tarafındaki bağlantı havuzuna bırakmak.
Bu, kaynakların sınırsız olduğu anlamına gelmiyor. Veri hacmi ve sorgu etkinliği arttığında kaynak kullanımını izlemek, her veritabanında olduğu gibi burada da optimal performans için mantıklı. Microsoft SQL sınırsız kaynak sunmuyor; sunduğu şey, boşta bağlantıların adanmış sunucu süreçleri gerektirmediği bir bağlantı mimarisi.
Pratik kazanç, uygulamanızın veritabanının bağlantı mimarisine göre tasarlanmak yerine kendisi için en uygun bağlantı ve transaction desenlerini seçebilmesi. PostgreSQL’den gelen bir ekip için bu, bakım yükünden ve sürekli tetikte olma zorunluluğundan bir kalem eksilmesi demek.
Kaynaklar ve İleri Okuma
- PostgreSQL to SQL Field Notes: Connections — Jerry Nixon (Azure SQL Dev Corner)
- Azure SQL Dev Corner blogu
- .NET ve PostgreSQL ile Azure’da Cache’i Ciddiye Almak

20+ yıl deneyimli Azure Solutions Architect. Microsoft sertifikalı bulut mimari ve DevOps danışmanı. Azure, yapay zekâ ve bulut teknolojileri üzerine Türkçe teknik içerikler üretiyor.

Yorum gönder