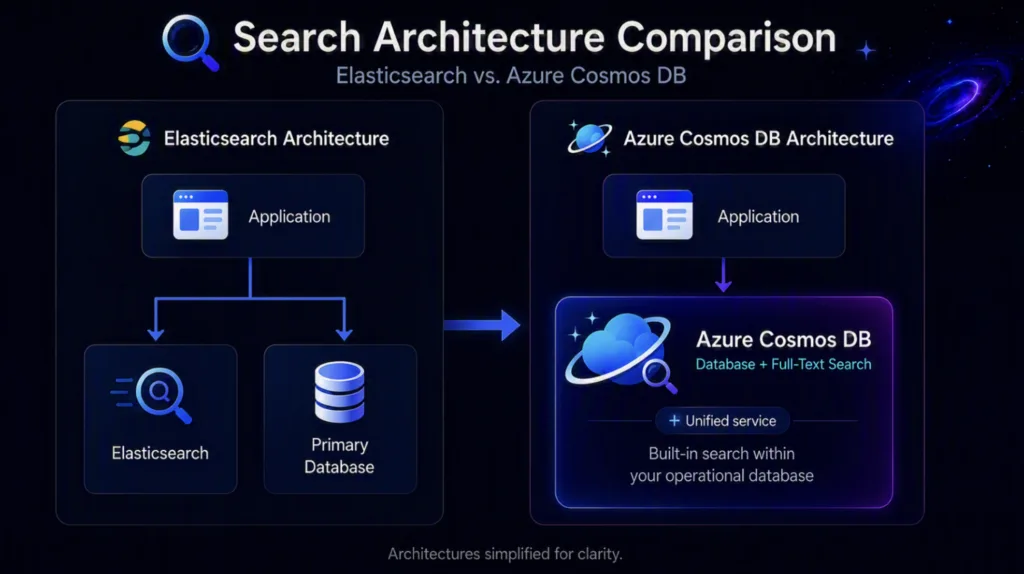

Arama yükü ayrı bir Elasticsearch kümesinde dönen ekipler için Azure Cosmos DB, operasyonel veriyle aramayı tek bir yönetilen serviste toplayan bir alternatif sunuyor. Microsoft’un Azure Cosmos DB blogunda Madeline Egan’ın yayımladığı geçiş rehberi, iki mimarinin nerede ayrıştığını, Elasticsearch’teki yaygın arama yeteneklerinin Azure Cosmos DB tarafındaki karşılıklarını ve geçiş kararından önce tartılması gereken tasarım ödünleşimlerini anlatıyor. Bu yazıda rehberin içeriğini, kaynaktaki kapsamı bozmadan Türkçe olarak özetliyorum.
Aramanın uygulama yığınındaki yeri
Rehberin merkeze aldığı ayrım teknik bir özellik listesinden önce geliyor ve doğrudan mimariyle ilgili. Elasticsearch tipik olarak ayrı bir arama kümesi olarak çalışır, Azure Cosmos DB ise aramayı veritabanında duran operasyonel verinin üzerinde sağlar.
Ayrı bir arama katmanı, operasyonel veritabanıyla arama indeksi arasına bir veri hareketi yolu ekler. Verinin kopyalanması, indekslenmesi ve arama sonuçlarının uygulamanın güncel durumunu yansıtması için senkron tutulması gerekir. Azure Cosmos DB’de veritabanı ve full-text search yetenekleri aynı servisin parçası olduğundan bu senkronizasyon yolu ortadan kalkıyor.
Karşılığında arama artık bir veritabanı iş yükü gibi tasarlanmak durumunda. Kaynak şu başlıklara dikkat çekiyor: bölümleme (partitioning), indeksleme, sorgu şekli, sonuç kümesinin büyüklüğü ve request unit (RU) tüketimi. Arama sorgularının maliyeti, veritabanının geri kalan trafiğiyle aynı bütçeyi paylaşıyor. Bölümleme tarafında tasarım kararlarının etkisini daha önce partition key değiştirme yolları yazısında ele almıştım.
Elasticsearch yeteneklerinin Azure Cosmos DB karşılıkları
Rehberdeki eşleme tablosu hangi yeteneğin bugün desteklendiğini, hangisinin önizlemede olduğunu, hangisinin de uygulama tarafında çözülmesi gerektiğini net biçimde ayırıyor.
| Yetenek | Durum | Ayrıntı |
|---|---|---|
| Çok dilli full-text search | Var | Çoklu dil desteği önizleme aşamasında. Desteklenen dillerin listesi dokümantasyonda yer alıyor. |
| İfade (phrase) araması | Var | Birebir ifadeler için FullTextContains; terim tabanlı eşleşme için FullTextContainsAll / FullTextContainsAny. |
| Stopword temizliği | Var | Tokenization ve stemming ile birlikte full-text indeksleme içine gömülü. Şu an yalnızca İngilizce için geçerli; özel stopword listesi geliştirme aşamasında. |
| BM25 ile sıralama | Var | FullTextScore BM25 skoru döndürür; ORDER BY RANK ve RRF ile kullanılabilir. Skorlar şu an sorgu sonucunda projekte edilemiyor. |
| Fuzzy search | Önizleme | En fazla 2 edit distance ve 10 öneriye kadar. |
| Terim ağırlıklandırma | Ağırlıklar üzerinden | Ayrı bir term boosting operatörü yok. FullTextScore ve/veya VectorDistance üzerinde ağırlıklı Reciprocal Rank Fusion (RRF) kullanılıyor. Ağırlıklı BM25 geliştiriliyor. |
| Hibrit arama | Var | BM25 skorlaması ile vektör aramasını RRF üzerinden birleştirir. Hem full-text hem vektör politikası ve indeksi gerekir. |
| Faceting | Aggregate ile | Özel bir facet operatörü yok. Aynı arama kriteri üzerinde GROUP BY, COUNT ve COUNTIF gibi aggregate sorgularla facet sayıları üretiliyor. |
| Sayfalama | Var | Ölçeklenebilir sayfalama için continuation token. OFFSET LIMIT çalışır ancak derin sayfalama yerine küçük atlamalar için uygundur. |
| Hit highlighting | Yakında | Yerleşik vurgulama geliştirme aşamasında. |
| Skor açıklaması / projeksiyonu | Yakında | Sıralama skorlarının, skor bileşenlerinin, ağırlık faktörlerinin ve alaka açıklamalarının uygulamaya açılması geliştiriliyor. |
| Autocomplete / typeahead | Uygulama tarafında | Dokümante edilmiş yerleşik bir autocomplete API’si yok. Uygulama mantığı veya prefix alanları kullanılabilir. |
Pratikte en çok soruyu doğuran iki nokta tabloda görünüyor. Skor projeksiyonunun henüz olmaması, alaka düzeyini uygulama arayüzünde göstermek ya da debug etmek isteyen ekipler için bugünlük bir kısıt. Term boosting’in ayrı bir operatör yerine RRF ağırlıklarıyla yapılması da Elasticsearch sorgularının birebir çevrilmeyeceği anlamına geliyor.
Hibrit arama ve vektör tarafı
Azure Cosmos DB’nin hibrit arama yaklaşımı, BM25 tabanlı full-text skorlamasıyla vektör aramasını Reciprocal Rank Fusion üzerinden birleştiriyor. Bunun için koleksiyonda hem full-text hem de vektör politikasının ve indeksinin tanımlı olması gerekiyor. Ayrı bir boosting operatörü olmadığından ağırlıklı alaka düzeyi kurgusunun temeli de aynı RRF mekanizması. Vektör tarafındaki gelişmeleri vektörlerin kendini güncellemesi yazısında ayrıca ele almıştım.
Performans ve maliyet
Rehbere göre birçok iş yükünde ayrı bir Elasticsearch arama katmanını tek bir yönetilen servisle değiştirmek toplam maliyeti düşürebilir, performansı iyileştirebilir. Gerekçesi mimarinin kendisinde: altyapı, operasyon ve senkronizasyon yükü azalıyor.
Kaynak buraya bir çekince koyuyor. Gerçek maliyet, gecikme ve verim; indeksleme davranışı, sorgu desenleri, veri dağılımı, erişilebilirlik gereksinimleri ve bölgesel replikasyon gibi iş yüküne özgü etkenlere bağlı. Rehber “daha ucuz olur” ifadesini genel bir garanti olarak değil, değerlendirilmesi gereken bir hipotez olarak sunuyor.
Bugün karşılığı olmayan yetenekler
Kaynağın ana çıkarımı, Azure Cosmos DB’nin ayrı bir arama katmanı olmadığı, içinde full-text, vektör ve hibrit arama yetenekleri bulunan bir operasyonel veritabanı olduğu. Bu bütünleşik yaklaşım mimariyi sadeleştirebilir ama iki sistem birebir aynı değil.
Rehberde, Elasticsearch’te bulunan bazı özelleşmiş yeteneklerin Azure Cosmos DB’de şu an yerleşik olarak bulunmadığı ya da uygulama tarafında çözülmesi gerektiği açıkça belirtiliyor:
- Eş anlamlı (synonym) yönetimi
- Yakınlık (proximity) araması
- Gelişmiş autocomplete
- Yerleşik hit highlighting
Kaynak, Azure Cosmos DB arama yeteneklerinin hızla geliştiğini, düzenli olarak yeni işlevler eklendiğini de ekliyor. Geçiş planlaması yapan ekiplere önerilen yaklaşım, bugün mevcut olan özellikleri değerlendirirken platformun süregelen yatırımını da hesaba katmak.
Serinin devamı
Bu yazı, Elasticsearch tabanlı arama iş yüklerinin Azure Cosmos DB’ye taşınmasını konu alan bir serinin ilk parçası. Kaynakta belirtilen yol haritası şöyle:
- İkinci yazı: Elasticsearch mapping’lerinin Azure Cosmos DB’ye taşınması, yani indeks tanımları, analyzer’lar ve alan yapılandırması.
- Üçüncü yazı: Sorgu çevirisi, bir Elasticsearch Search Request’inin Azure Cosmos DB sorgu desenine nasıl dönüştürüleceği.
Bu ilk yazı bir uygulama kılavuzu değil, karar öncesi bir değerlendirme çerçevesi. Elasticsearch kümesini kapatmadan önce, arama sorgularınızın hangi özelliklere gerçekten bağımlı olduğunu yukarıdaki tabloyla karşılaştırmak makul bir başlangıç noktası.
Kaynaklar ve İleri Okuma
- Azure Cosmos DB Migration Guide for Elasticsearch Users (Madeline Egan, Azure Cosmos DB Blog)
- Azure Cosmos DB full-text search dokümantasyonu
- Hibrit arama (full-text + vektör, RRF)
- FullTextScore ve BM25 sıralaması
- Reciprocal Rank Fusion (RRF) sorgu fonksiyonu
- Desteklenen stopword listesi
- Sayfalama ve continuation token kullanımı
- Azure Cosmos DB Blog

20+ yıl deneyimli Azure Solutions Architect. Microsoft sertifikalı bulut mimari ve DevOps danışmanı. Azure, yapay zekâ ve bulut teknolojileri üzerine Türkçe teknik içerikler üretiyor.
İlgili Yazılar

Bu içerik işinize yaradı mı?
Benzer içerikleri kaçırmamak için YouTube ve GitHub hesaplarımı takip edin.
Biz de Elasticsearch cluster’ı yönetmekten yorulmuştuk açıkçası, ayrı bir servis ayakta tutmak baya iş yükü oluyordu. RU tüketimi konusunda biraz endişem var ama, hibrit arama sorguları çok pahalıya gelmiyor mu pratikte?
Biz de bir projede Elasticsearch cluster’ı ayakta tutmaktan yorulmuştuk, tek serviste toplanması cidden cazip. Ama RU maliyeti konusu beni korkutuyor açıkçası, yoğun arama sorgularında fatura nasıl şişiyor, o konuda biraz daha detay paylaşır mısınız?
Elasticsearch cluster’ı ayakta tutmanın maliyetinden bıkmıştık, Cosmos DB’de hepsini tek yerde toplamak cazip duruyor. Yalnız hibrit arama sorgularında RU tüketimi nasıl, pahalıya patlıyor mu merak ettim. Bu arada şu yazınız da elime geçti, çok işime yaradı: GitHub External Custom Properties ile CMDB Senkronu — https