Azure SQL Hyperscale’in Socrates Mimarisi Nasıl Çalışır
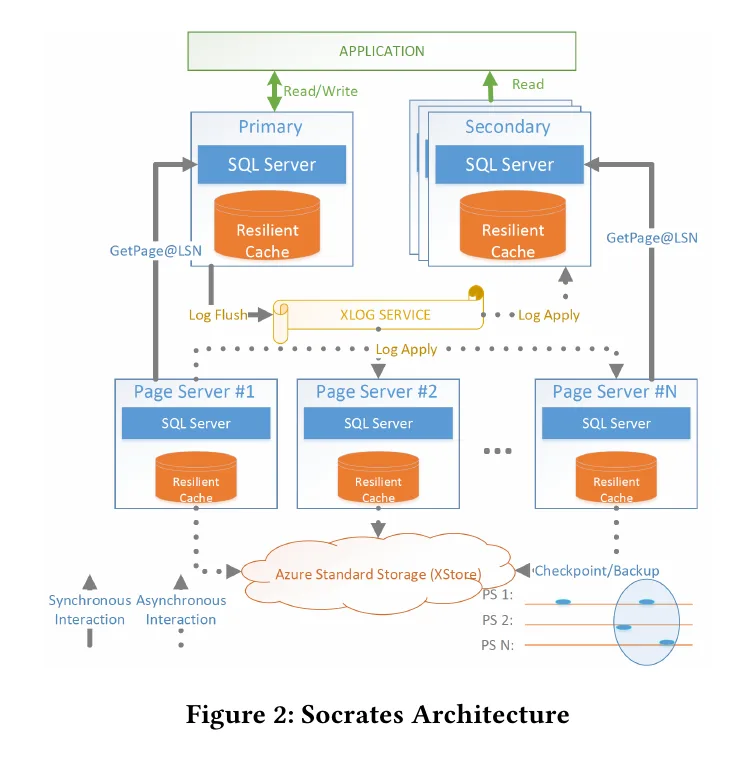
Azure SQL Database Hyperscale’in 50 TB’lık bir veritabanını dakikalar içinde geri yükleyebilmesinin ya da yeni bir okuma replikasını veri boyutundan bağımsız olarak ayağa kaldırabilmesinin arkasında 2019’da SIGMOD’da yayımlanan Socrates: The New SQL Server in the Cloud makalesi var. Anna Hoffman’ın Azure SQL Dev Corner’da başlattığı “Under the Hood” yazı dizisinin ilk bölümü bu makaleyi okunabilir bir anlatıma dönüştürüyor. Socrates’in çözdüğü problem, veritabanını dört katmana ayıran tasarım ve bunun bugün Hyperscale kullanıcısına kazandırdıkları aşağıda.
Problem: Tek makineye yüklenen dört iş
Geleneksel SQL Server mimarisi tek bir düğümden aynı anda dört işi yapmasını bekler: sorguları işlemek, transaction log’u yönetmek, veriyi depolamak ve kopyaları senkron tutmak. Aynı yaklaşım Azure SQL Database’in Business Critical katmanı için de geçerli. Makale bunu dolandırmadan söylüyor; bu gereksinimlerin tamamını bulutta geleneksel monolitik veritabanı mimarisiyle karşılamak mümkün değil.
Socrates öncesi tasarım (yazıdaki adıyla “full-replica mimarisi”) hala Business Critical’ı çalıştırıyor. Veritabanı, bir Always On availability group’a oldukça benzeyen 3-4 replikalık küçük bir küme olarak çalışır. Bir primary okuma ve yazmaları kabul eder, üç secondary primary’nin log’unu yeniden oynatarak güncel kalır. Her replika kendi yerel SSD’sinde verinin tam kopyasını tutan, kendi kendine yeten eksiksiz bir SQL Server örneğidir. Primary düşerse secondary’lerden biri terfi eder, her şeye zaten sahip olduğu için de hızlıca devralır.
Hızın kaynağı da tavanın kaynağı da bu simetri:
- Her replikanın tüm veritabanını alacak kadar yerel diske ihtiyacı var; yani veritabanı tek bir makinenin diskini asla aşamaz.
- Yedekler primary üzerinde çalışır ve canlı trafikle I/O için yarışır.
- Yeni replika eklemek, ağ üzerinden taze bir tam kopya aktarmak (seeding) anlamına gelir.
Bu işlemlerin hepsi veri boyutuyla ölçeklenir. Sonuçta servisin destekleyebileceği en büyük veritabanı, rutin operasyonların maliyetini herkes için belirliyordu. Pratik tavan yaklaşık 4 TB’tı.
Dört katmanlı tasarım
Socrates veritabanını dört katmana ayırır ve her katman tek bir işi iyi yapar.
Compute düğümleri
Sorgu işlemciyi çalıştırır. Bir primary okuma ve yazmaları, secondary’ler salt okunur sorguları karşılar. Compute düğümünün veritabanının tam kopyasını saklaması gerekmez; veriyi iki katmanlı bir önbellekle yakın tutar, bellekte buffer pool, yerelde ise RBPEX (Resilient Buffer Pool Extension) adı verilen akıllı SSD önbelleği vardır. Bu SSD önbelleği buffer pool’u belleğin ötesine taşır, böylece okumaların daha büyük kısmı bir page server’a gitmeden yerelde karşılanır.
XLOG servisi
Transaction log’un sahibidir. Primary commit ettiğinde log blokları hızlı bir SSD “landing zone”a düşer, XLOG da bunları ihtiyacı olan herkese dağıtır. Dayanıklılık (durability) burada yaşar. Business Critical’daki AG teknolojisinden farklı olarak log “push” edilmez; herkes log’u çeker ve yalnızca kendi önbelleğindeki sayfalara ait log kayıtlarını uygular.
Page server’lar
Verinin sahibidir. Her biri veritabanının bir dilimini tutar, dilimini güncel tutmak için log kayıtlarını uygular, istek üzerine de tek tek sayfaları sunar. Büyük ölçüde “full covering” çalışırlar; yani compute düğümünde bulunmayan herhangi bir sayfa buradan getirilebilir. Yeni bir compute düğümü bu yüzden bu kadar hızlı ayağa kalkıyor, seeding ya da veri kopyalama yok, yalnızca yönlendirme var.
XStore
Azure Storage üzerine kurulmuştur; uzun vadeli dayanıklı kopyayı tutar ve yedeklemeleri snapshot’lar aracılığıyla yürütür. Daha uzun saklama için destage edilmiş log’u da barındırır.
GetPage@LSN: Katmanları birbirine bağlayan çağrı
Bu dört katmanı birleştiren mekanizma GetPage@LSN çağrısı. Önbelleğinde olmayan bir sayfaya ihtiyaç duyan compute düğümü (primary ya da replika fark etmez), ilgili sayfayı log içinde belirli bir noktada ister. Makalenin ifadesiyle page server, o LSN’e kadar log’u uygulayana dek bekler ve sayfayı ondan sonra döndürür; replikanın bayat bir sayfa görmesi böyle engellenir. Küçük bir fikir, ama sonuçları büyük.
Makaleye göre log ve depolama katmanlarını ayırmak, dayanıklılığı (log tarafından sağlanır) ve erişilebilirliği (depolama katmanı tarafından sağlanır) birbirinden ayırıyor. Bu iki endişe ayrıldığı anda yedekleme bir compute problemi olmaktan çıkıyor, restore bir kopyalama işlemi olmaktan çıkıyor, replika eklemek de veritabanı boyutuyla orantılı kalmıyor.
Kazanımlar: Makaledeki karşılaştırma
Makalenin kendi öncesi-sonrası tablosu kazanımın en net özeti:
| Ölçüt | Full-replica mimarisi (önce) | Socrates |
|---|---|---|
| Maksimum veritabanı boyutu | 4 TB | 100 TB |
| Erişilebilirlik | %99,99 | %99,999 |
| Ölçekleme işlemleri | O(veri) | O(1) |
| Depolama kopyası | 4× | 2× |
| Commit gecikmesi | 3 ms | 0,5 ms’nin altı |
| Log throughput | 50 MB/s | 100+ MB/s |
İki satır özellikle dikkat çekiyor. Ölçekleme işlemleri O(veri)’den O(1)’e geçti, yani okuma replikası eklemek artık veritabanınızın büyüklüğüne bağlı değil. Depolama yükü de kabaca yarıya indi, dört kopyadan iki kopyaya. (Yazıda, dayanıklılık için her XStore blob’unun ayrıca replike edildiği notu da düşülüyor.)
Önbellek davranışı beklenenden iyi sonuç vermiş. 1 TB’lık bir veritabanında verinin %22’sini kapsayan bir önbellek okumaların %52’sini karşılamış. 30 TB’lık bir TPC-E veritabanında ise verinin yalnızca %1’ini kapsayan önbellek okumaların %32’sini karşılamış. Gerçek iş yükleri çarpık (skewed) dağılır, mimari de bu özelliğe yaslanıyor.
Güncelleme ağırlıklı yük altında Socrates 89,8 MB/s log aktarımı sağlarken full-replica mimarisi 56,9 MB/s’de kalmış, yaklaşık %58 daha düşük bir değer. Nedeni, yedeklerin log ile yarışmak yerine XStore snapshot’larına taşınmış olması.
Bugün Hyperscale’de karşılığı
Hyperscale kullanıyorsanız bu tasarımın devamını çalıştırıyorsunuz demektir. Yazıda sayılan pratik sonuçlar şunlar:
- Yedekler neredeyse anlık ve compute kaynağınızı tüketmiyor; çünkü depolama katmanında snapshot tabanlı çalışıyorlar.
- Restore süresi büyük ölçüde veritabanı boyutundan bağımsız. 50 TB’ı geri yüklemek, 1 TB’ı geri yüklemekten 50 kat zor değil.
- Okuma replikaları hızlı ayağa kalkıyor; named replica’ların raporlama veya AI iş yüklerini işlem trafiğinden yalıtmak için bir desen olarak çalışmasının nedeni bu.
- Depolama 128 TB’a kadar otomatik büyüyor, önceden provizyon gerekmiyor.
- Log throughput bugün 150 MB/s’ye ulaşıyor, makale yayımlandığında bildirilen 100+ MB/s değerinin üzerinde.
- Continuous priming, replikaların önbelleklerinde en sıcak sayfaları tutan yeni bir kavram olarak kullanılabiliyor.
Makaledeki bir cümle tasarım felsefesi gibi de okunuyor; depolamaya devredilebilen her veritabanı işlevi, sistemin iki darboğazı olan primary compute düğümünü ve log’u rahatlatır. Yazıya göre bu cümle yedi yıl sonra hala ekibin karar verme biçimini tarif ediyor.
Veritabanı seçerken bu neden önemli?
Hoffman’a göre geliştiriciler veritabanlarını çoğu zaman “modern, cloud-native olanlar” ve “şirketimde zaten olan ilişkisel olan” diye ikiye ayırıyor. Socrates bu ayrımın işe yaramadığı bir örnek. Compute-storage ayrışması, servis olarak log ve sayfa düzeyinde uzaktan veri çekme, bugün cloud-native olarak pazarlanan sistemlerde karşımıza çıkan mimari hamlelerin aynısı. Microsoft SQL bunu üretimde, ölçekte ve tam T-SQL uyumluluğunu koruyarak yapmış.
İşin ilginç tarafı da burada. Mevcut uygulamanız, mevcut sorgularınız ve mevcut araçlarınız çalışmaya devam ediyor, ama alttaki mimari tamamen değişmiş durumda.
Yazar, makalenin kapsamı dışında Hyperscale hakkında birkaç noktayı daha vurguluyor: ayrıca edinilecek, satın alınacak veya bakımı yapılacak bir yazılım yok ve fiyatlandırma açık kaynak seviyesinde konumlandırılmış. Mimari büyük veritabanları için tasarlanmış olsa da küçük veritabanlarında da çalışıyor, 10 GB’tan başlıyor. Serverless auto-pause ve resume desteğinin public preview’da duyurulduğu, yani isteğe bağlı olarak atıl durumda sıfıra ölçeklenebildiği de belirtiliyor.
Makalenin arkasındaki ekip ve devamı
Socrates: The New SQL Server in the Cloud makalesi Microsoft Azure ve Microsoft Research’ten Panagiotis Antonopoulos, Alex Budovski, Cristian Diaconu, Alejandro Hernandez Saenz, Jack Hu, Hanuma Kodavalla, Donald Kossmann, Sandeep Lingam, Umar Farooq Minhas, Naveen Prakash, Vijendra Purohit, Hugh Qu, Chaitanya Sreenivas Ravella, Krystyna Reisteter, Sheetal Shrotri, Dixin Tang ve Vikram Wakade tarafından yazıldı. Serinin bir sonraki yazısının konusu ise Constant Time Recovery ve 12 saatlik bir kurtarmanın nasıl 3 dakikaya indiği olarak duyuruluyor.
Kaynaklar ve İleri Okuma
- Anna Hoffman — The paper that split the database in four: inside Azure SQL Database Hyperscale, aka Socrates
- Socrates: The New SQL Server in the Cloud (SIGMOD 2019, PDF)
- Hyperscale dağıtık fonksiyon mimarisi (Microsoft Learn)
- Hyperscale servis katmanı dokümantasyonu
- Hyperscale replika türleri ve named replica
- Hyperscale veritabanı oluşturma hızlı başlangıcı
- Azure SQL Foundations serisi
- Azure SQL YouTube kanalı
- Azure SQL Dev Corner blogu
- İlgili yazı: Kodlama Ajanları Neden Azure SQL Database Seçiyor?

20+ yıl deneyimli Azure Solutions Architect. Microsoft sertifikalı bulut mimari ve DevOps danışmanı. Azure, yapay zekâ ve bulut teknolojileri üzerine Türkçe teknik içerikler üretiyor.
Yorum gönder