Azure SQL DiskANN Vektör İndeksi GA: T-SQL ile Arama
Microsoft, DiskANN tabanlı vektör indeksi ve vektör aramanın Azure SQL Database, always-up-to-date güncelleme politikasını kullanan Azure SQL Managed Instance ve Microsoft Fabric’teki SQL database üzerinde genel kullanıma (GA) sunulduğunu duyurdu. Yaklaşık en yakın komşu (ANN) araması artık ayrı bir vektör veritabanı kurmadan, doğrudan SQL motorunun içinde çalışıyor. Vektörler ilişkisel verinin yanında durabiliyor, benzerlik araması da uygulamanın halihazırda güvendiği filtreler, join’ler, güvenlik politikaları ve işlemsel (transactional) davranışla birlikte kullanılabiliyor.
Vektör indeksi neden gerekiyor?
Uygulamalar metin, görsel, ürün ve doküman gibi içeriklerin anlamsal karşılığını embedding’lerle, yani vektörlerle temsil ediyor. Vektör benzerliği araması sayesinde bir sorgu, aynı anahtar kelimeleri içermeyen ama kavramsal olarak ilgili sonuçları da getirebiliyor.
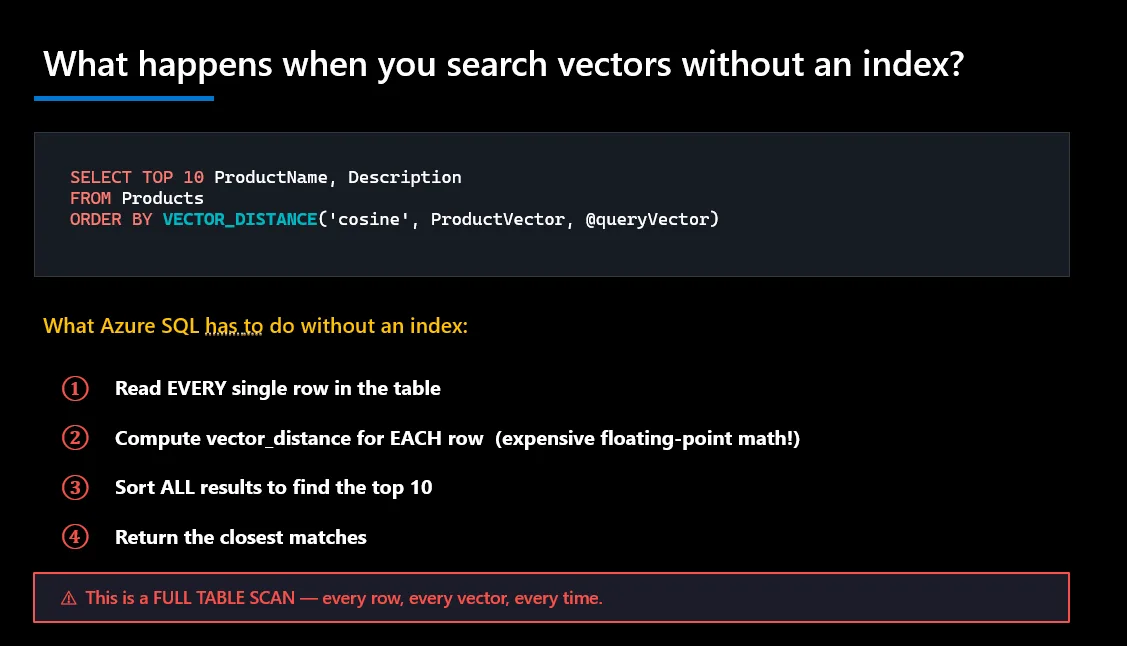
Vektör indeksi olmadan yapılan tam (exact) arama ise sorgu vektörü ile koşulları sağlayan her vektör arasındaki mesafeyi tek tek hesaplar, sonra en yakın eşleşmeleri belirleyip sıralar. Küçük veri kümelerinde ve kesin sonuç gerektiren iş yüklerinde bu yaklaşım iyi çalışır, ancak vektör sayısı büyüdükçe hesaplama maliyeti de büyür.
DiskANN benzerlik aramayı nasıl hızlandırıyor?
DiskANN vektör indeksi, veri kümesi büyüdükçe ilgili adayları verimli biçimde bulmayı hedefleyen bir yaklaşık en yakın komşu arama yolu sunuyor. Her vektörü değerlendirmek yerine gezinilebilir (navigable) bir graf kuruluyor, veritabanı motoru da bu graf üzerinden en umut vadeden adaylara doğru ilerliyor. Benzer sonuçları bulmak için yapılması gereken iş böylece azalırken arama kalitesi yüksek kalıyor.
Adındaki iki parça ne anlatıyor?
Kaynak yazıda ismin iki tasarım tercihine işaret ettiği belirtiliyor:
- ANN (Approximate Nearest Neighbor): Sorgu vektörü veri kümesindeki her vektörle karşılaştırılmaz; indeks üzerinde verimli bir keşif yapılarak olası en yakın komşular belirlenir.
- Disk: DiskANN, büyük vektör indekslerinin tamamen pahalı RAM’e bağımlı olmaması için tasarlandı. SSD destekli depolamayı kullanabilir ve görece küçük bir bellek ayak izi korur; devasa veri kümelerine ölçeklenmesini sağlayan nokta da bu.
Yani “ANN” tarafı indeksin ne kadarının taranması gerektiğini azaltıyor, “Disk” tarafı da tüm vektör indeksini bellekte tutma zorunluluğunu ortadan kaldırıyor.
Önizlemeden üretime geçerken gelen yetenekler
DiskANN vektör indeksleri genel önizlemede sunulduğunda ekip, müşterileri doğrudan operasyonel verileri üzerinde vektör arama uygulamaları kurmaya davet etmişti. Microsoft’a göre o dönemdeki geri bildirimler bugün GA olan deneyimi şekillendirdi. GA ile gelenler şunlar:
- Büyük vektör koleksiyonları için DiskANN tabanlı yaklaşık en yakın komşu araması
- Tam
INSERT,UPDATEveDELETEdesteği ile asenkron vektör indeksi bakımı - İlişkisel koşullar (predicate) uygulanırken istenen sayıda uygun sonucu bulmak için yinelemeli (iterative) filtreleme
- Optimizer destekli yürütme: SQL, sorgu bağlamına göre tam ya da yaklaşık vektör arama stratejisi arasında seçim yapabiliyor
- Birleştirilebilir (composable) T-SQL: vektör arama; mevcut filtreler, join’ler, iş mantığı ve güvenlik denetimleriyle birlikte çalışıyor
Vektör arama böylece SQL’in doğal bir parçası gibi davranıyor. Uygulamaların ayrıca işletmesi ve veritabanıyla uyumlu tutmaya çalışması gereken bağımsız bir erişim (retrieval) sistemi kalmıyor.
Geliştirmeden üretime aynı sorgu
Uygulamalar, yaklaşık sonuçların kabul edilebilir olduğunu TOP (N) WITH APPROXIMATE ifadesiyle belirtiyor:
SELECT TOP (10) WITH APPROXIMATE
p.ProductId,
p.Name,
s.distance
FROM VECTOR_SEARCH(
TABLE = dbo.Products AS p,
COLUMN = Embedding,
SIMILAR_TO = @query_vector,
METRIC = 'cosine'
) AS s
WHERE p.IsActive = 1
ORDER BY s.distance;
Aynı sorgu, uygulama ve verisi büyüdükçe çalışmaya devam edebiliyor. Yürütme stratejisini optimizer seçiyor; veri boyutunu, koşulları, mevcut indeksleri ve talep edilen sonuç sayısını, kısacası sorgunun tamamını değerlendiriyor.
Benzerlik aramasını ilişkisel gereksinimlerle birleştirmek
Kaynakta sıralanan tipik kullanım örnekleri şöyle:
- Yalnızca stokta bulunan ürünleri döndürmek
- Yalnızca geçerli kullanıcının erişim yetkisi olan dokümanlar içinde arama yapmak
- Önerileri bölgeye veya kategoriye göre sınırlamak
- Vektör arama sonuçlarını operasyonel tablolarla join’lemek
- Mevcut satır düzeyi güvenlik (row-level security) politikalarını uygulamak
Geliştiriciler de uygulamalarının zaten kullandığı ilişkisel ve işlemsel yeteneklerden vazgeçmeden anlamsal erişim ekleyebiliyor.
Data Exposed bölümü ve milyar vektör demosu
Microsoft, yeni bir Data Exposed bölümünde Azure SQL vektör aramasının müşteri uygulamaları prototipten üretime geçerken nasıl evrildiğini anlatıyor. Bölümde ayrıca Azure SQL Database Hyperscale üzerinde bir milyar vektör üzerinde vektör arama gösteriliyor.
Nasıl başlanır?
Vektör aramayı kendi uygulamanıza eklemek için resmi belgeler, hızlı başlangıç ve örnek depoları aşağıdaki bağlantılarda. Sözdizimi tarafını CREATE VECTOR INDEX ve VECTOR_SEARCH dokümantasyonu anlatıyor, uçtan uca senaryolar için de Azure-Samples deposundaki örnekler var.
Kaynaklar ve İleri Okuma
- DiskANN Vector Index and Vector Search Are Now Generally Available in Azure SQL (Pooja Kamath, Azure SQL Dev Corner)
- CREATE VECTOR INDEX (Transact-SQL) dokümantasyonu
- VECTOR_SEARCH (Transact-SQL) dokümantasyonu
- DiskANN Vector Index hızlı başlangıç örnekleri (GitHub)
- Azure SQL Database vektör arama örnek deposu
- DiskANN vektör indeksi iyileştirmeleri
- Optimizer zekâsının vektör aramayı nasıl değiştirdiği
- Data Exposed: Azure SQL vektör aramasının evrimi (video)
- Microsoft Research: DiskANN / Project Akupara
- Azure SQL’de DiskANN Vektör İndeksleri: Gerçekten Neler Değişti?

20+ yıl deneyimli Azure Solutions Architect. Microsoft sertifikalı bulut mimari ve DevOps danışmanı. Azure, yapay zekâ ve bulut teknolojileri üzerine Türkçe teknik içerikler üretiyor.
Yorum gönder