Content Understanding: Grounding ve Confidence Kalibrasyonu
Belgeden veri çıkarmak otomasyonun ilk adımı. İş, çıkarılan değer bir eylemi tetiklemeye başlayınca zorlaşıyor: fatura ödeniyor, poliçe kaydı güncelleniyor, hasar dosyası bir sonraki adıma taşınıyor. Uygulamanın elinde bir cevabın bulunması o noktada yetmiyor; cevabın nereden geldiğini ve ne kadar güvenilir olduğunu da bilmesi gerekiyor. Microsoft Foundry blogunda Joe Filcik ve Colin Murphy, Azure Content Understanding’in grounding ve confidence mekanizmalarının üretimde nasıl kullanıldığını, bu sinyallerin insan incelemesini nasıl önceliklendirdiğini anlatıyor.
Grounding: Bu değer belgede nereden geldi?
Content Understanding bir faturadan “Invoice Total: $14,228.02” çıkardığında, grounding bu yapılandırılmış değeri belgede onu destekleyen içeriğe bağlıyor. Yazıya göre son sürümde grounding çıkarım akışının daha derinine yerleştirildi; bu değişiklik ortalama çıkarım token kullanımını %28’e varan oranda azaltırken doğruluğu da iyileştirdi.
Bu bağ, uygulamanın yapabileceklerini değiştiriyor:
- Kanıtı sonuçla birlikte göstermek: İnceleyen kişi kaynağı belgede aramak zorunda kalmıyor.
- Değeri kanıtıyla birlikte doğrulamak: Çıkarılan değer, dayanağı olmayan bir iddia gibi ele alınmıyor.
- Denetim izi tutmak: İş kaydından, değerin geldiği sayfaya kadar geriye doğru izlenebilirlik kalıyor.
Grounding çıkarımı denetlenebilir hale getiriyor, confidence ise hangi çıkarımın denetlenmeye değdiğini söylüyor.
Confidence skoru aslında neyi ölçüyor?
Confidence skoru, belirli bir alan sonucunun ne kadar güvenilir olduğuna dair öğrenilmiş bir tahmin; desteklenen alanlarda 0 ile 1 arasında bir değer olarak dönüyor. Yazıya göre son güncelleme, AUROC ile ölçülen confidence skoru doğruluğunu %14’e varan oranda iyileştirdi.
Bu skor, dil modelinin “kendimden ne kadar eminim” beyanı değil. LLM’ler kendi cevapları konusunda fazlasıyla özgüvenli olabiliyor, yanlış okudukları bir değeri doğrusu kadar akıcı biçimde anlatabiliyor. Content Understanding bunun yerine, doğru ve yanlış çıkarımlarda görülen örüntüleri tanımak üzere eğitilmiş ayrı bir confidence modeli kullanıyor.
Hangi sinyallere bakılıyor?
- Belge ve kanıt: Değerin sayfada nerede ve nasıl göründüğü, grounding’in bulduğu destekleyici kanıtın niteliği.
- Alan ve sonuç: Alanın türü, şema yapısındaki konumu ve tahmin edilen değerin biçimi.
- Etiketli örnekler (varsa): Sonucun, analyzer’a verilen örneklerle karşılaştırılması.
- Modelin kendi davranışı: Çıkarım sırasında ortaya çıkan belirsizlik işaretleri veya alanla tam örtüşmeyen değer göstergeleri gibi tanılama bilgileri.
Bu sinyaller confidence modeline giriyor, model de alan sonucu için bir skor üretiyor. Skor metnin yanında bağlamı da yansıtıyor; aynı değer üst düzey bir alan olarak göründüğünde başka, bir tablo ya da nesne içinde yer aldığında başka skor alabiliyor, çünkü çevresindeki sinyaller ve tipik hata örüntüleri farklı.
Model tarafında bir nokta daha var. Microsoft bu modeli kendi derlediği verilerle eğitiyor, müşteri verisiyle değil. Model servis düzeyinde paylaşılıyor; bugün Content Understanding müşterileri her müşteri veya analyzer için ayrı bir confidence modeli eğitmek yerine aynı temel modeli kullanıyor, Microsoft da modeli servisin bir parçası olarak periyodik şekilde güncelliyor.
Kalibrasyon: Global skoru iş kuralına çevirmek
İyi bir global confidence skoru, belirli bir iş akışı için karar kuralı demek değil. Belge türleri, alanlar ve kaynaklar farklı davranabiliyor. Müşteriler bu yüzden confidence modelini yeniden eğitmiyor; kendi iş akışlarından gelen, insan tarafından doğrulanmış örneklere karşı skorları değerlendirip iş hedeflerine uyan eşikleri seçiyor.
Skoru risk için bir sıralama sinyali olarak düşünmek en doğrusu. Çok sayıda çıkarım arasında düşük skorlu sonuçlar, yüksek skorlulara kıyasla hataların çok daha büyük bir bölümünü barındırmalı. AUROC da zaten bunu, skorun doğruları yanlışlardan ne kadar iyi ayırdığını ölçüyor.
Üretimdeki örnek: sigorta iş akışı
Yazıda aktarılan vakada büyük bir sigorta kuruluşu, Microsoft’un Forward Deployed Engineering ekibiyle birlikte bir belge işleme çözümü kurdu. Akış şöyle işliyor: Content Understanding önce gelen sayfaları form türüne göre sınıflandırıp bölümlüyor, kapsamdaki her bölüm sürümünü belirlemek için form türüne özgü bir sınıflandırıcıya, ardından ilgili alan çıkarım analyzer’ına gidiyor.
Geniş belge kataloğunu yönetmek için sınıflandırma iki katmanda birden fazla analyzer’a bölündü, segmentasyon yalnızca ilk katmanda etkinleştirildi. Content Understanding v1 sınıflandırmalar için confidence skoru döndürmediğinden, tüm sınıflandırmalar insan incelemesinde kaldı. Belge türü ve çıkarım yapılandırması için geçerli bir kalibrasyon bulunan yerlerde ekip, alan düzeyinde confidence kurallarını human-in-the-loop (HITL) inceleme aracındaki öncelik etiketlerini doldurmak için kullandı. Sigorta verisi hassas olduğundan her alan yine insan tarafından kontrol edildi; etiketler otomatik geçişi değil, dikkatin nereye yoğunlaşacağını belirledi. Daha az hassas iş akışlarında ise aynı kalibre edilmiş kurallar, işaretlenmemiş değerleri doğrudan geçirmek için kullanılabilir.
Yazıda belirtilen sonuçlara göre çözüm, önceki çözümlere kıyasla insan inceleme yükünde yaklaşık %50 azalma ve %75 daha hızlı form onboarding sağladı. Bunu mümkün kılan unsurlar arasında %97’nin üzerinde sayfa düzeyi sınıflandırma doğruluğu ve hataları barındırma olasılığı en yüksek sonuçlara odaklanan confidence/grounding tabanlı yönlendirme yer alıyor.
Adım 1: Skordan değil, belgelerden başlayın
Herhangi bir eşik belirlemeden önce, iş akışındaki farklı belge türlerinde çıkarımın ne kadar doğru olduğuna bakmak gerekiyor. Gerçek iş akışları tek tip belge işlemiyor; farklı formlar, aynı formun farklı sürümleri ve farklı kaynaklardan gelen belgeler söz konusu. Bir vergi formunun 2024 sürümü çok güvenilir çıkarılırken 2026 sürümü yeni bir alan ekleyebilir, bir bölümü taşıyabilir veya tabloyu değiştirebilir. Benzer şekilde bazı tedarikçiler temiz ve tutarlı belgeler gönderirken, bazıları yoğun, taranmış veya sıra dışı belgeler gönderebilir.
Bu nedenle insan tarafından doğrulanmış sonuçları belge türüne göre ayırmak gerekiyor. Belge türünü iş akışınız için anlamlı düzeyde tanımlayın: form ailesi, sürüm ve kaynak (müşteri, tedarikçi, gönderim kanalı). Kalibrasyon yalnızca değerlendirilen belge türleri ve kaynakları, analyzer yapılandırması ile alan şeması ve kullanılan çıkarım modeli (LLM) için geçerli; başka belgelere, analyzer’lara veya model sürümlerine taşınabilir bir garanti değil.
Adım 2: Eşikleri belge türü ve alan bazında belirleyin
Her belge türü içinde, confidence’ın her alan için doğru ve yanlış çıkarımları gerçekten ayırıp ayırmadığını ölçün. Eşikleri insan tarafından kontrol edilmiş örneklere ve açık iş hedeflerine göre seçin, sonra ayrılmış (held-out) belgelerde doğrulayın. Yüksek genel doğruluk tek başına daha gevşek bir eşiği haklı çıkarmaz; sıkı bir eşik de hataları güvenilir biçimde ayırt edemeyen bir confidence sinyalini telafi edemez.
Alanlar da aynı ayrımı hak ediyor; poliçe numarası için iyi çalışan bir eşik, el yazısı bir adres veya tablo satırı için kötü bir tercih olabilir. Bazı alanlarda confidence ile doğruluk arasındaki ilişki otomasyona izin verecek kadar güçlü değil, o alanlar incelemede kalıyor.
Boş alanlar ayrı bir kural istiyor. Sistem hiçbir şey döndürmediğinde iki olasılık var: belgede gerçekten o değer yok ya da sistem onu kaçırdı. Bu iş akışında confidence, boş sonuçlarda bu iki durumu güvenilir biçimde ayıramadı. Boş değerler bu yüzden, ilgili alan için “hiçbir şey”in ne sıklıkta doğru cevap olduğuna dayanan ayrı bir politikaya bağlandı.
Adım 3: Eşiği sezgiyle değil veriyle seçin
0.8 bana güvenli geliyor” bir politika değil. Ekibin izlediği tekrarlanabilir süreç şöyle:
- Doğrulanmış örnek toplayın. Kapsamdaki her belge türü, sürümü ve kaynağından gerçek, temsil gücü olan üretim belgeleri toplayın; cevaplar insan tarafından onaylanmış olsun. El yazısı, tarama kalitesi ve eksik değerler gibi gerçek değişkenliği dahil edin. Sentetik veya temsil gücü düşük örnekler, üretim kalibrasyon verisinin yerini tutmaz.
- Her belge türünü ve alanı ölçün. Doğruluğu kaydedin ve confidence’ın doğruyu yanlıştan gerçekten ayırıp ayırmadığını kontrol edin.
- Bir hedef belirleyin. Örneğin incelemenin bilinen hataların en az %80’ini yakalaması gibi. Bu, sürecin merkezindeki iş kararı; temelinde o iş akışında hatayı yakalamanın iş değeri yatıyor.
- Hedefi karşılayan eşiği bulun. Her alan ve belge türü için, hata kapsama hedefini karşılarken en az sayıda değeri incelemeye gönderen kesme noktasını seçin. Hiçbir eşik hedefi karşılamıyorsa o alan incelemede kalsın.
- Ayrılmış belgelerde doğrulayın. Politikayı, onu oluştururken kullanılmayan belgelerde test edin; kalibrasyon kümesindeki sonuçlar fazla iyimser olabilir.
- Üretimi izleyin ve geri besleyin. İncelenen her sonuç yeni bir doğrulanmış örnek olur. Çıkarım doğruluğunu ve inceleme politikasının performansını belge türü ve alan bazında periyodik olarak ölçen bir “dış döngü” kurun; hedefli incelemeye işaretlenmemiş sonuçlardan da insan kontrollü örnekler alın. Confidence skoru dağılımları tek başına doğruluğu kanıtlamaz.
Müşteri projesinde bu dış döngü, gelen belgelerde veya Content Understanding’in servis tarafı davranışında yeniden kalibrasyon gerektirebilecek değişiklikleri yakalamak için önerildi. Belge sürümleri veya kaynakları, analyzer yapılandırması, alan şeması ya da temeldeki LLM değiştiğinde ve izleme çıkarım veya confidence performansında kayma gösterdiğinde yeniden doğrulama yapılması gerekiyor. Kalibrasyon güncellemesi, iş akışının confidence skorlarını yorumlama biçimini değiştirir; servisin confidence modelini yeniden eğitmez.
Ölçülen sonuçlar
Değerlendirme, 1.000’den fazla üretim belgesindeki 22.000’den fazla alan değerini kapsadı ve müşteriden gelen insan kontrollü cevaplara göre puanlandı. Politikalar bir belge kümesinde öğrenildi, ayrı bir held-out kümede test edildi.
Held-out kümede %41 daha az alan değeri hedefli incelemeye seçildi, bu daha küçük seçim yine de bilinen çıkarım hatalarının %80’inden fazlasını içeriyordu. Karşılaştırma noktası, her alan değerinin incelenmesi. Bu, %41 daha az personel zamanı ya da hatasız otomasyon anlamına gelmiyor; bazı hatalar hedefli kümenin dışında kaldı. Ekibe sağladığı şey, incelemeyi ölçülebilir biçimde önceliklendirme imkanı oldu. Daha az hassas bir iş akışında aynı politika, ödünleşimi net görerek inceleme kuyruğunu küçültebilir.
Kendi verinizle denemek: açık kalibrasyon laboratuvarı
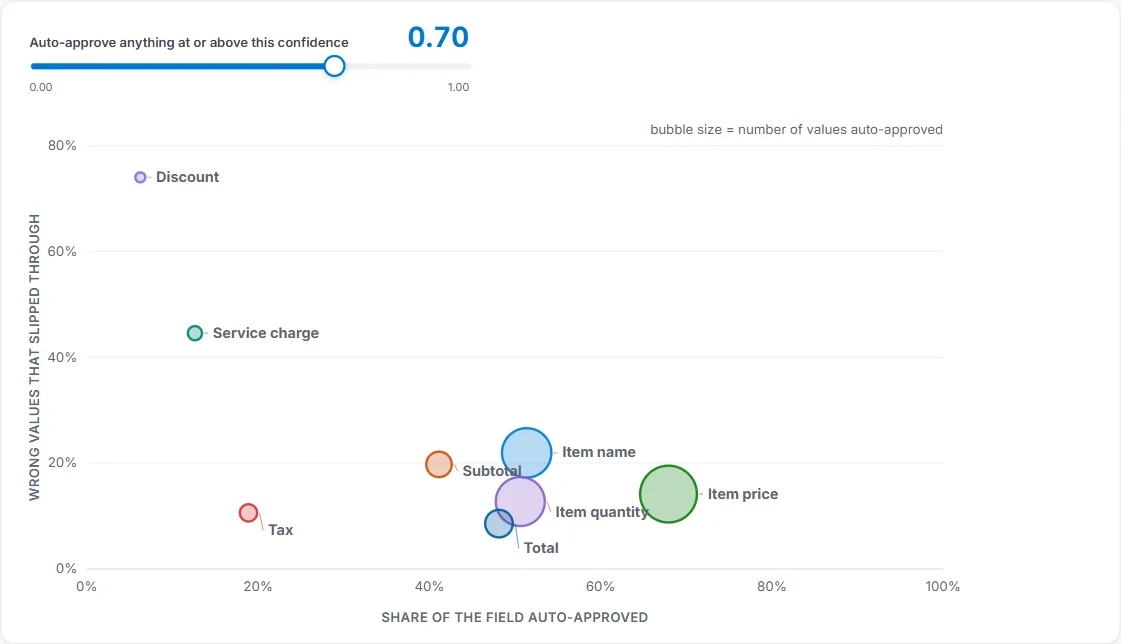
Yazarlar, başka ekiplerin bir müşterinin belgelerine erişmeden aynı kararı inceleyebilmesi için herkese açık bir kalibrasyon laboratuvarı hazırladı. Laboratuvar, açık CORD v2 veri kümesinden 1.000 fiş üzerinde gerçek Content Understanding sonuçlarını kullanıyor: 800’ü politika kurmak, 200’ü değerlendirme için ayrılmış durumda.
Laboratuvardan öne çıkanlar:
- Tek bir eşik alandan alana çok farklı davranıyor. Aynı confidence eşiğinde bazı fiş alanları çok az yanlış değeri geçirirken, bazıları büyük bir kısmını geçiriyor.
- Kazanç hem dolu hem boş alanlardan geliyor. Kalibrasyon kümesinde, hataların %77’sini incelemeye gönderen bir politika, dolu alanlardan gelen tüm değerlerin yaklaşık %11’ini ve boş alanlardan gelenlerin yaklaşık %13’ünü otomatik onaylıyor; geriye insan kontrolü için %77 kalıyor. Bu rakamlar örnekleyicidir, müşteri sonucu değildir.
- Çıktı kasıtlı olarak basit: Uygulamanızın yeni çıkarımları yönlendirmek için kullanabileceği alan düzeyinde kurallardan oluşan bir tablo. Kalibrasyon Content Understanding’i yeniden eğitmiyor, yönlendirme de başka bir AI modeli çağırmıyor.
Güvenilir otomasyon için çıkarımlar
- Her sonucu grounding’e bağlayın: Yapılandırılmış çıktıyı kaynak kanıtıyla bağlantılı tutun.
- Confidence’ı risk sıralaması olarak kullanın: Size önce nereye bakacağınızı söyler.
- Eşikten önce belge türüne göre sınıflandırın: Belge türleri, sürümleri ve kaynakları doğruluğu çoğu zaman tek bir kesme noktasından daha iyi açıklar.
- Eşikleri veriyle, belge türü ve alan bazında belirleyin: Bir iş hedefi seçin, ona göre ölçün ve held-out belgelerde doğrulayın.
- Boş alanlara kendi politikasını verin.
- Döngüyü çalışır tutun: Yeni form sürümleri ve yeni kaynaklar, kalibre edilmesi gereken yeni segmentlerdir.
Yazının özetlediği çerçeve net: algı sistemin okumasını, muhakeme anlamasını sağlıyor; grounding doğrulamayı mümkün kılıyor, confidence riski görünür yapıyor, kalibrasyon ise bu riski bir iş kararına dönüştürüyor. Güvenilir belge otomasyonu hiç hata yapmayan bir modelden gelmiyor; cevaplarını denetlenebilir kılan, belirsizliği açığa çıkaran ve uygulamaya ne zaman devam edip ne zaman ikinci bir bakış isteyeceğini ilkeli biçimde söyleyen bir sistemden geliyor.
Kaynaklar ve İleri Okuma
- devblogs.microsoft.com
- devblogs.microsoft.com
- devblogs.microsoft.com
- devblogs.microsoft.com
- devblogs.microsoft.com
- From extraction to action: Using grounding and confidence to build reliable document workflows (Microsoft Foundry Blog)
- Cha Zhang: Azure Content Understanding ve Document Intelligence üzerine
- İnteraktif açıklayıcı: inceleme yükü ve hata kapsamı ödünleşimi
- Kalibrasyon laboratuvarı notebook’u
- Azure Content Understanding Prebuilt Analyzers (İngilizce orijinal yazı)
- Azure Content Understanding Prebuilt Analyzers: Alan Bilgisi
- Azure Document Intelligence mi Content Understanding mi?
- Azure Content Understanding ile Belgeleri Akıllı İş Akışına Çevirmek

20+ yıl deneyimli Azure Solutions Architect. Microsoft sertifikalı bulut mimari ve DevOps danışmanı. Azure, yapay zekâ ve bulut teknolojileri üzerine Türkçe teknik içerikler üretiyor.


Yorum gönder