Azure Content Understanding Prebuilt Analyzers: Alan Bilgisi
Belge işlemede metni çıkarmak artık işin yalnızca başlangıcı. Uygulamaların ve ajan tabanlı iş akışlarının ihtiyacı başka: belgenin yapısını ve örtük iş anlamını, aşağı akıştaki sistemlerin doğru yorumlayabileceği biçimde yakalamak. Azure Content Understanding’in prebuilt analyzer‘ları bu boşluğa oynuyor; fatura, vergi formu ve kimlik belgesi gibi yaygın belge aileleri için hazır, bakımı yapılan çıkarım bileşenleri sunuyor. Bu yazıda bir prebuilt analyzer’ın şemadan farkını, uygulamanıza döndürdüğü sinyalleri ve Microsoft’un paylaştığı vergi formu kıyaslamasının ne gösterdiğini ele alıyorum.
Şema çıktı sözleşmesidir, doğruluk garantisi değil
Şema alan adlarını, tiplerini, zorunlu özellikleri, iç içe nesneleri ve izin verilen değerleri tanımlar; yapılandırılmış çıkarımın çıktı sözleşmesidir yani. Ama bir şema totalAmount alanının sayı olmasını zorunlu kılabilse de eksi işaretinin düşüp düşmediğini, tarihin yanlış yerel ayara göre yorumlanıp yorumlanmadığını, değerin yanlış satır kaleminden gelip gelmediğini söyleyemez. Sonuç şemaya tam uyar, iş tarafında pahalı bir hataya yol açar.
Content Understanding, custom analyzer’larla şema öncelikli bir başlangıcı kolaylaştırıyor. Geliştirici her alanı doğal dilde tarif ediyor, analizörün ne çıkarması ya da üretmesi gerektiğini tanımlıyor; böylece esnek bir zero-shot başlangıç oluyor. Özel yüklerde ise ekiplerin temsilci belgelerle test etmesi, etiketli örnekler eklemesi, alan tanımlarını iyileştirmesi ve sonuçları kendi gereksinimlerine göre değerlendirmesi gerekiyor. Platform bu işin büyük kısmını kolaylaştırıyor, ortadan kaldırmıyor.
Prebuilt analyzer neyi paketliyor?
Alana özel bir prebuilt analyzer, bakımı yapılan bir şemayı belge ailesine dair öğrenilmiş bilgiyle birlikte paketliyor: alanların nasıl ifade edildiği, genellikle nerede göründükleri, ilişkili değerlerin birbirine nasıl bağlandığı, hangi gösterimlerin eşdeğer sayıldığı, hangi belirsizliklerin sık hatalara yol açtığı. Ortaya çıkan analizör alanları destekleyici kanıtla ilişkilendirmek, değerleri yorumlayıp normalleştirmek, eksik veya belirsiz bilgiyi ele almak ve sonuçları kaynağa dayandırmak üzere tasarlanıyor.
Pratikte bu, aynı belge varyasyonlarını toplama, aynı yaygın alanları etiketleme ve çıkarım konvansiyonlarını sıfırdan geliştirme yükünü Microsoft’un üstlenmesi demek. Geliştiriciye kalan, sonuçların uygulamasına nasıl oturduğu: hangi alanlar kritik, hangi iş kuralları geçerli, hangi vakalar insan incelemesi gerektiriyor.
Uygulamanın eline geçen üç sinyal
Alan bilgisi yalnızca çıkarılan değere değil, o değeri güvenle kullanmak için gereken sinyallere de yansıyor. Desteklenen alanlar için bir prebuilt analyzer şunları döndürebiliyor:
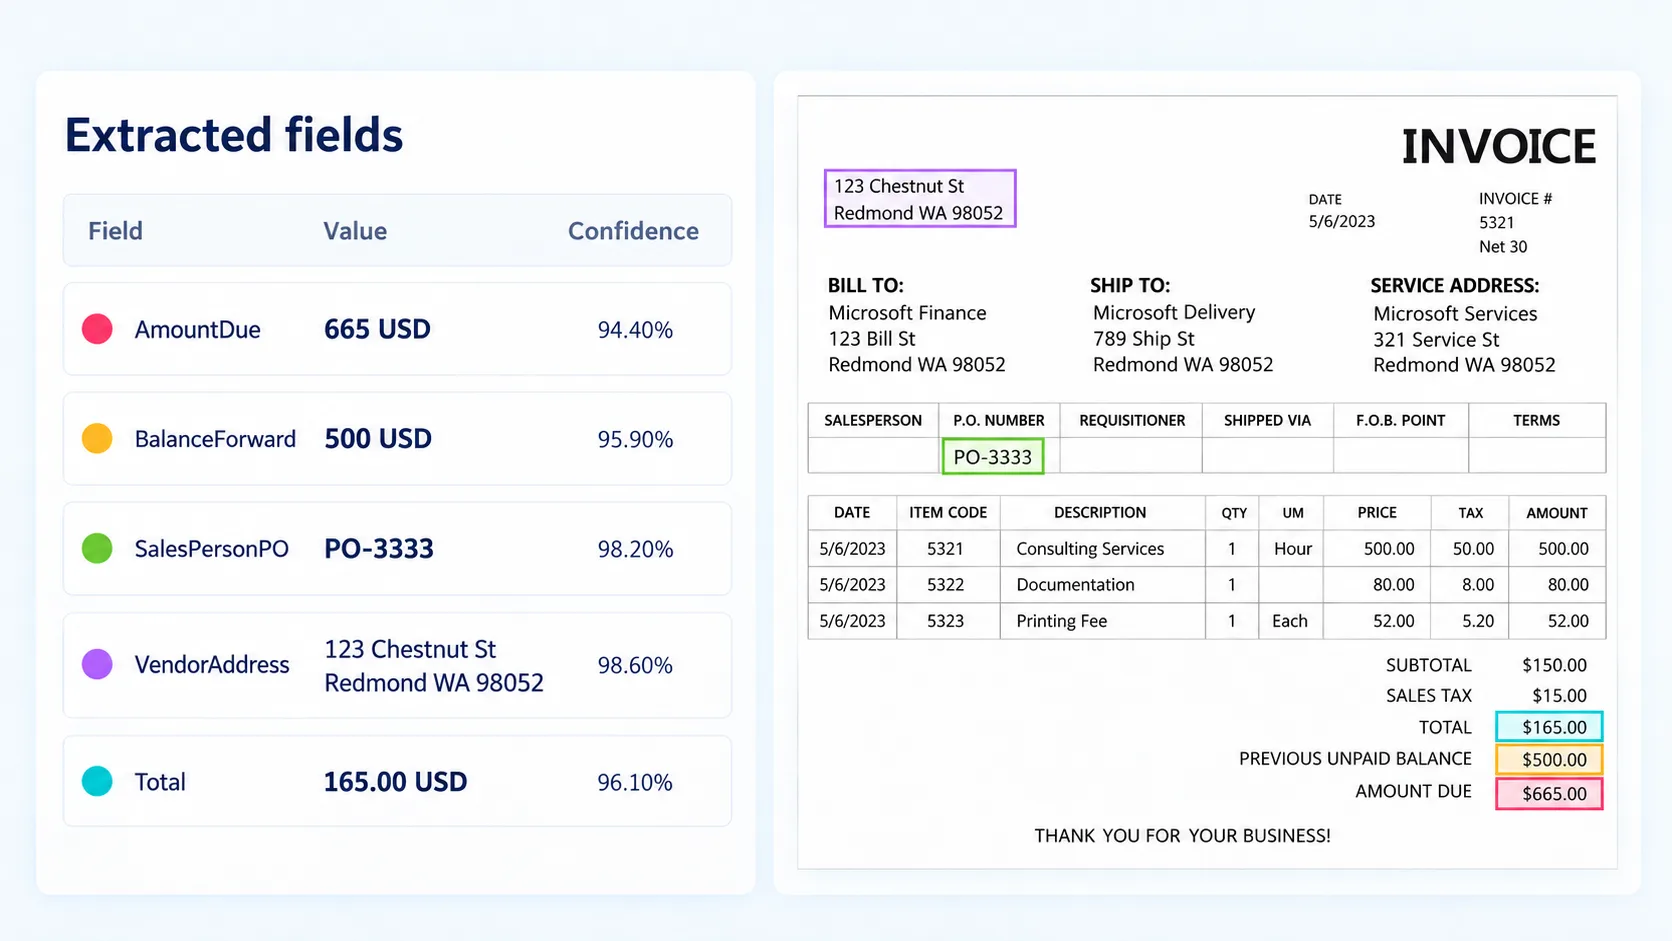
- Value: Uygulama için tiplendirilmiş, yapılandırılmış sonuç. Desteklenen tarih ve sayılar kanonik biçime normalleştiriliyor, basılı gösterimi yorumlama işi her uygulamaya bırakılmıyor.
- Confidence: Analizörün kesinliğini tahmin eden skor. Straight-through processing veya insan incelemesi eşiklerini belirlemekte kullanılabiliyor.
- Grounding: Sonucu belgedeki kanıta bağlayan kaynak aralığı, sayfa ve koordinat bilgisi.
Bir borç hesapları (accounts payable) akışında örneğin prebuilt-invoice analizörü P.O. numaralarını ve kalem tutarlarını tahmini güven skoru ve grounding ile çıkarıyor. İş akışı bu sonuçları kendi iş kurallarına göre doğrulayabiliyor, itiraz edilen bir değerin kaynağını işaretleyebiliyor, belirsiz sonuçları incelemeye yönlendirebiliyor.
Alan bilgisi nerede fark yaratıyor?
Ara toplam, vergi, fatura toplamı, kalan bakiye ve iç içe satır kalemleri içeren bir faturayı düşünün. Zor olan kısım bir sayıyı bulmak değil; her tutarın ne anlama geldiğini ayırt etmek, miktar ve fiyatı doğru satır kalemiyle eşleştirmek, tarih ve sayıları belge bağlamında yorumlamak. Microsoft bu analizörleri desteklenen her belge ailesi için bölge, yerleşim ve iş senaryosu farklılıklarını kapsayan yüksek kaliteli, temsilci örneklerden kuruyor; amaç, analizörün karşılaşacağı gerçek dünya dağılımını yansıtmak.
Yaklaşım, belge ailesi temel bilgisini LLM’in genel bilgisi ve anlamsal yetenekleriyle birleştirmeye dayanıyor. Düzen ve belgeye özgü desenler aday değerleri bulmaya yardım ediyor, anlamsal anlama ise bu değerlerin ne ifade ettiğini ve hangi alana ait olduğunu belirliyor. prebuilt-invoice analizörü istenen alan için doğru değeri ayırt ediyor, algılanan yerel ayara göre normalleştiriyor, güven skoru ile grounding kanıtı eşliğinde yapılandırılmış biçimde dönduruyor.
Son işleme adımı da aynı bağlamı kullanıyor. OCR binlik ayırıcı virgülün yerine nokta koyduğunda $1,000 değeri $1.000 olarak okunabiliyor, ikincisini ondalık gibi ayrıştırmak da değeri bin kat değiştiriyor. Bu hatayı düzeltmek belgenin sayısal konvansiyonlarını ve çevredeki kanıtı bilmeyi gerektiriyor.
Konum ile anlamın birlikte önem kazandığı bir başka örnek W-2 formu. W-2 prebuilt analizörü, metin birden fazla satıra yayılsa bile box c içindeki işveren adı ile adresini ayırıyor. Kimlik numaraları da benzer bir zorluk çıkarıyor: banka hesabı, şirket kayıt numarası ve VAT numarası farklı iş amaçlarına hizmet ediyor ve her biri doğru tarafla ilişkilendirilmeli. Çekçe bir faturada Číslo účtu (hesap numarası) ile IČO (kimlik numarası) alanlarını müşteri bloğunda ayırt etmek, belge tipi bilgisi olmayan basit bir çıkarım aracı için zorlayıcı olabiliyor.
Birden fazla belge tipi: composed çözümler
Alan bilgisi, iş akışına farklı türde belgeler geldiğinde de devreye giriyor. Alana özel analizör kataloğunda procurement, ABD vergi formları ve ABD mortgage başvurusu (intake) için composed çözümler var. Bu senaryolarda belgelerin çıkarımdan önce tanımlanması gerekiyor.
Composed prebuilt analyzer’lar sınıflandırma ve yönlendirmeyi uzmanlaşmış çıkarımla birleştiriyor: belgeyi aile düzeyindeki analizöre gönderiyorsunuz, analizör belgenin bölümlerini sınıflandırıp uygun çıkarıcıya ve şemaya yönlendiriyor. Bir mortgage intake servisi böylece dosya adlarına güvenmek ya da kendi form sınıflandırıcısını işletmek yerine her gelen dosyayı prebuilt-mortgage.us analizörüne verebiliyor. Tanınan formlar kendi uzman analizörlerine yönlendiriliyor, uygulamaya sonuçları doğrulamak ve istisnaları ele almak kalıyor.
Vergi formu kıyaslaması ne gösteriyor?
Alan bilgisini paketlemek, ancak çalışma zamanında ekonomik biçimde uygulanabiliyorsa işe yarıyor. Microsoft’un bu amaçla sunduğu en yeni yaklaşım Advanced Contextualization, desteklenen prebuilt analizörlerde kalite, maliyet ve gecikme dengesini iyileştirmeyi hedefliyor.
Etkiyi ölçmek için en yeni nesil prebuilt vergi analizörleri 19 ABD vergi formu kategorisinde değerlendirilmiş. Kıyaslama Azure Document Intelligence, Azure Content Understanding 1.0 GA ve Advanced Contextualization’lı Azure Content Understanding 2.0 Preview’u kategori düzeyinde F1 skoru, modellenmiş maliyet ve ortalama gecikme üzerinden karşılaştırıyor. 19 kategori değerinin eşit ağırlıklı ortalamaları:
| Sistem | Ortalama F1 | 1.000 sayfa başına modellenmiş ortalama maliyet | Ortalama gecikme indeksi (ACU 1.0 GA = 10) |
|---|---|---|---|
| Azure Document Intelligence | 96,71% | $10 | 4,4 |
| Azure Content Understanding 1.0 GA | 97,41% | $16,23 | 10 |
| Azure Content Understanding 2.0 Preview | 99,32% | $8 | 4,9 |
1.0 GA ile karşılaştırıldığında 2.0 Preview eşit ağırlıklı ortalama F1’i 1,91 puan artırmış, ortalama modellenmiş maliyeti %51, ortalama gecikmeyi yine %51 düşürmüş. Azure Document Intelligence karşısında ise ortalama F1 2,61 puan yüksek, modellenmiş maliyet %20 düşük, ortalama gecikme %10 daha yüksek çıkmış. Kategori düzeyindeki sonuçlar da ortalamalar kadar önemli, çünkü 2.0 Preview 17 kategoride 1.0 GA’dan yüksek F1 kaydetmiş, 18 kategoride daha hızlı olmuş, 19 kategorinin tamamında daha düşük modellenmiş maliyet üretmiş.
Bu maliyet rakamlarının modellenmiş kıyaslama tahminleri olduğunu atlamayın. Gerçek maliyet geçerli içerik çıkarımı ve contextualization sayaçlarına, Foundry model kullanımına ve güncel fiyatlara bağlı. Kendi yükünüzü tahmin etmek için API’nin usage değerlerini güncel fiyatlandırma rehberiyle birlikte kullanmanız öneriliyor.
Karmaşık bir örnek: 1099 Combo
Kıyaslama kategori genelinde performansı özetliyor. Tek bir karmaşık belgede güvenilir çıkarımın ne gerektirdiğini görmek içinse konsolide 1099 beyanı (1099 Combo) iyi bir örnek: tek bir aracı kurum paketi, birden fazla vergi formunu, yoğun tabloları ve kuruma ve vergi yılına göre değişen biçimleri bir arada barındırabiliyor.
Temsilci veri bu varyasyonları ortaya çıkarıyor, ama tamamen kural tabanlı bir yaklaşım yerleşime özgü istisnaların sürekli büyüdüğü bir yığına dönüşebiliyor; her yeni kurum biçimi ya da vergi yılı revizyonu bakımı gereken kural sayısını artırıyor. LLM anlamsal esneklik getiriyor, buna karşılık okuma sırasını yanlış yorumlayabiliyor veya tablo başlığı, satır ve tutar arasındaki ilişkiyi kaybedebiliyor. 2.0 Preview’daki 1099 Combo prebuilt analizörü alan kurallarını, yerleşim imzalarını ve LLM’in anlamsal anlayışını birleştirerek her satır değerini doğru satır, sütun ve çıktı alanıyla ilişkilendirmek için gereken bağlamı sağlıyor.
Kendi belge ailenizle nasıl deneyebilirsiniz?
Prebuilt analyzer kataloğu procurement belgeleri, ABD vergi formları, kimlik belgeleri, finansal tablolar, mortgage belgeleri, sözleşmeler ve kişisel kayıtları kapsıyor. İş akışınıza en yakın belge ailesi ve alan şemasıyla başlamak mantıklı bir giriş noktası.
Başlangıçta önce Content Understanding Studio hızlı başlangıcını izleyip bir Foundry kaynağı bağlamanız ve gerekli model dağıtımlarını yapılandırmanız gerekiyor. Sonrası amacınıza bağlı: Studio üzerinden bir belgeyi ve çıkarılan alanlarını incelersiniz, REST API ile analizi ve sonuç alımını uygulamanıza entegre edersiniz (preview-only analizörler için preview API sürümünü kullanarak), prebuilt iş akışınızı karşılamıyorsa custom analyzer oluşturursunuz.
Bir prebuilt’in size uyup uymadığını ölçmek için kaynakta önerilen yöntem şu adımlardan oluşuyor:
- Content Understanding Studio’da belge ailenize karşılık gelen prebuilt analizörü seçin.
- Temiz dijital dosyalar, taramalar ve yerleşim varyantlarından oluşan temsilci bir karışımı çalıştırın.
- Her değeri beklenen sonuçla karşılaştırın; grounding ve confidence bilgisini inceleyin, kendi iş doğrulama kurallarınızı uygulayın.
- Alan düzeyinde kaliteyi, tamamlanma oranını, gecikmeyi ve API’nin contextualization ile model token’ları için döndürdüğü
usagedeğerlerini kaydedin. - Aynı dosyalarla analizi tekrarlayıp tutarlılığı ölçün; sonra doğrulama ve insan inceleme eşiklerini iş riskine göre belirleyin.
Tekrarlanabilir karşılaştırma için koşular arasında aynı API sürümünü ve analizör yapılandırmasını kullanmanız, bunları sonuçlarla birlikte kayıt altına almanız öneriliyor. Belge aileniz henüz kapsanmıyorsa, Microsoft yeni prebuilt önerilerini topladığını belirtiyor.
Şema beklenen çıktıyı tanımlıyor, alan bilgisi ise hangi kanıtın hangi alana ait olduğunu belirlemeye yardım ediyor. Advanced Contextualization da desteklenen prebuilt çözümlerde çıkarım kalitesini, güvenilirliğini ve maliyet verimliliğini iyileştirmek üzere tasarlanmış durumda. Microsoft, bu yeteneğin prebuilt çözümlere yayılmasında henüz başta olduklarını söylüyor.
Kaynaklar ve İleri Okuma
- Azure Content Understanding Prebuilt Analyzers: packaging domain knowledge for document AI (Chu Lahlou, Microsoft Foundry Blog)
- Why content extraction still matters in the GenAI era
- Microsoft Learn: Prebuilt analyzers kavram dokümanı
- Content Understanding Studio hızlı başlangıç
- REST API ile analiz ve sonuç alma
- Custom analyzer oluşturma eğitimi
- Azure Content Understanding Studio
- W-2 prebuilt şema tanımı (GitHub)
- 1099 Combo prebuilt şema tanımı (GitHub)
- prebuilt-mortgage.us şema tanımı (GitHub)
- Azure Content Understanding: İçerik Çıkarımı Neden Kritik
- Azure Document Intelligence mi Content Understanding mi?

20+ yıl deneyimli Azure Solutions Architect. Microsoft sertifikalı bulut mimari ve DevOps danışmanı. Azure, yapay zekâ ve bulut teknolojileri üzerine Türkçe teknik içerikler üretiyor.

Yorum gönder